Fundamentos
Complexidade de algoritmos (Big-O) explicada com Python
Aprenda o que é a notação Big-O, conte passos em Python e compare O(1), O(log n), O(n) e O(n²) com exemplos que rodam no simulador, sem cronômetro.
Por Prof. Rodrigo Faustino · Atualizado em · 20 min de leitura
Nos artigos anteriores, duas perguntas ficaram no ar. Por que a busca binária é tão mais rápida que a busca linear? Por que o merge sort aguenta listas grandes e o bubble sort não? Em cada caso, houve uma contagem de comparações e uma frase do tipo "o trabalho cresce com o quadrado de n". Este artigo dá um nome e um método a essa ideia: a complexidade de algoritmos, escrita com a notação Big-O.
A pergunta que ela responde é simples: quando a entrada cresce, quanto o trabalho cresce? Um programa que leva um instante com 10 leituras pode levar uma eternidade com 10 mil, ou pode continuar instantâneo. Saber qual dos dois casos vale antes de rodar é uma das habilidades mais úteis de quem programa, e na ESP32 ela pesa mais do que no computador, porque a placa tem muito menos memória e velocidade. Todos os exemplos abaixo rodaram no simulador, e os números citados são os que ele produz. O que o Python do computador mostra de diferente está dito no texto.
Contar passos em vez de segundos
A primeira ideia que ocorre é cronometrar: rodar o programa e medir quanto tempo levou. O problema é que o tempo depende de tudo ao redor. A mesma função demora uma coisa no computador, outra na placa, outra se o computador estiver ocupado, e outra ainda se o simulador estiver rodando em uma aba cheia. Um número em segundos não diz nada sobre o algoritmo, só sobre aquela execução.
A saída é contar passos. Escolhe-se a operação que mais representa o trabalho, como uma comparação ou uma volta de laço, e conta-se quantas vezes ela acontece em função do tamanho n da entrada. A contagem é a mesma em qualquer máquina. Veja quatro funções com custos bem diferentes, cada uma devolvendo quantos passos deu:
def constante(lista):
    return lista[0], 1

def linear(lista):
    passos = 0
    total = 0
    for v in lista:
        total += v
        passos += 1
    return total, passos

def quadratico(lista):
    passos = 0
    for i in range(len(lista)):
        for j in range(len(lista)):
            passos += 1
    return passos

def logaritmico(n):
    passos = 0
    while n > 1:
        n = n // 2
        passos += 1
    return passos

for n in [10, 20, 40, 80]:
    lista = list(range(n))
    print(n, "O(1):", constante(lista)[1], "O(n):", linear(lista)[1], "O(n^2):", quadratico(lista), "O(log n):", logaritmico(n))
print(logaritmico(1000), logaritmico(1000000), logaritmico(1))
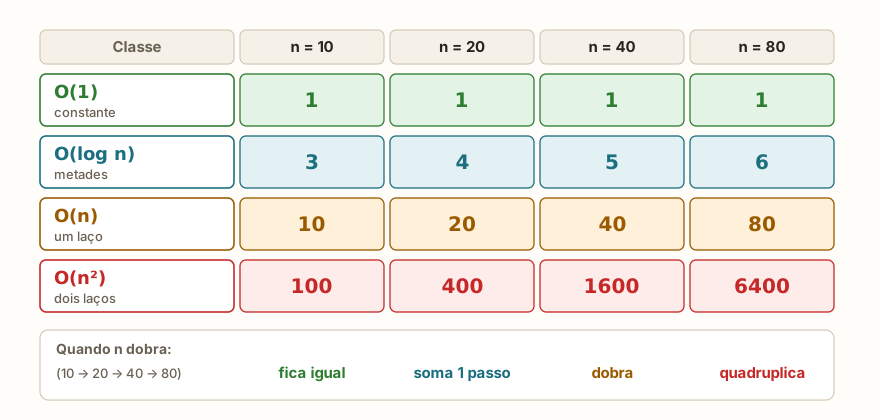
print("fim")A saída tem quatro linhas, uma por tamanho, e depois 9 19 0 e fim. Para n = 10, a primeira linha mostra O(1): 1, O(n): 10, O(n^2): 100 e O(log n): 3. Para n = 80, vêm 1, 80, 6400 e 6. Compare as colunas conforme n dobra de 10 para 20, para 40 e para 80. A de O(1) fica parada em 1. A de O(log n) sobe de 3 para 4, 5 e 6, só um passo a cada dobra. A de O(n) dobra junto, e a de O(n^2) quadruplica: 100, 400, 1600, 6400.
É isso que o Big-O descreve. Não interessa se um passo leva um microssegundo ou um milissegundo. Interessa o formato da curva que o trabalho desenha conforme n cresce.
Da ementa ao semestre planejado
- Plano de ensino e calendário montados sozinhos
- Diário de aulas pronto para colar no SIGA
- Slides e listas de exercícios com gabarito
Versão Community grátis · Windows
Medir o tempo também tem seu lugar
Contar passos não substitui o cronômetro, só responde a outra pergunta. Quando a dúvida é "este trecho cabe no tempo que tenho entre duas leituras do sensor?", a resposta vem de medir na própria placa. O MicroPython oferece time.ticks_ms() e time.ticks_us() para isso, e time.ticks_diff() para subtrair dois instantes de forma segura, já que o contador dá a volta depois de algum tempo:
import time
print(hasattr(time, "ticks_ms"), hasattr(time, "ticks_us"), hasattr(time, "ticks_diff"))
t0 = time.ticks_ms()
t1 = time.ticks_ms()
d = time.ticks_diff(t1, t0)
print(type(d), d >= 0)
print("fim")A saída é True True True, depois <class 'int'> True e fim. Essas funções são do MicroPython. No Python do computador elas não existem, e ali se usa time.perf_counter(). Os valores medidos não aparecem nos exemplos deste artigo porque mudam a cada execução, e uma saída que muda não serve para conferir o que se aprendeu. A regra prática é usar a contagem para escolher o algoritmo e o cronômetro para decidir se ele serve na placa.
O que o Big-O descreve
Escrever O(n) se lê "ordem de n", e diz que o trabalho cresce proporcionalmente a n. Duas regras transformam uma contagem exata numa classe:
- Só o termo que mais cresce conta. Se um algoritmo faz
3n² + 5n + 2passos, ele éO(n²), porque parangrande os outros termos somem diante do primeiro. - Constantes multiplicativas não contam.
3n²en²são da mesma classe, porque triplicar o tempo não muda a forma da curva.
A tabela abaixo mostra por que a primeira regra funciona. Ela calcula 3n² + 5n + 2 e a fatia que cabe ao termo 3n²:
for n in [10, 100, 1000, 10000]:
    total = 3 * n * n + 5 * n + 2
    so_n2 = 3 * n * n
    print(n, total, so_n2, round(100 * so_n2 / total, 2))
print("fim")A saída é 10 352 300 85.23, 100 30502 30000 98.35, 1000 3005002 3000000 99.83, 10000 300050002 300000000 99.98 e fim. Com 10 elementos, o termo 3n² responde por 85% do total. Com 10 mil, por quase 100%. Os termos 5n e 2 viram detalhe, e é por isso que o Big-O os joga fora.
Isso também mostra o limite da notação. O(n²) não diz que um algoritmo é lento, diz que ele fica lento quando n cresce. Com poucos elementos, um O(n²) simples pode ganhar de um O(n log n) complicado. A notação fala do futuro do algoritmo, não do presente.
As classes mais comuns
Quase tudo que se escreve cai numa destas classes, da mais barata para a mais cara:
O(1), constante. O trabalho não depende de n. Ler lista[0], ler lista[i], pegar len(lista), somar dois números, procurar uma chave num dicionário. Em geral, também lista.append(x).
O(log n), logarítmica. O trabalho cresce de leve, um passo a cada vez que o tamanho dobra. É o caso de quem corta o problema ao meio a cada passo, como a busca binária.
O(n), linear. Um laço que passa por cada elemento uma vez. Somar a lista, achar o maior, a busca linear, x in lista, sum(lista), max(lista).
O(n log n). O custo típico das boas ordenações, como o merge sort. Um pouco acima de linear.
O(n²), quadrática. Um laço dentro de outro, ambos percorrendo a lista. Bubble, selection e insertion sort, comparar todos os pares.
O(2ⁿ) e semelhantes, exponencial. O trabalho dobra, ou mais, a cada elemento a mais. Só serve para entradas minúsculas. O Fibonacci recursivo, mais adiante, é um exemplo.
Um jeito de reconhecer a classe olhando o código é contar laços aninhados: sem laço sobre a entrada o custo costuma ser O(1) ou O(log n), um laço sobre n é O(n), dois aninhados são O(n²). Mas atenção a três cuidados que a contagem de laços não pega.
def dois_lacos_seguidos(n):
    passos = 0
    for i in range(n):
        passos += 1
    for j in range(n):
        passos += 1
    return passos

def laco_triangular(n):
    passos = 0
    for i in range(n):
        for j in range(i):
            passos += 1
    return passos

def meio_com_barra(n):
    passos = 0
    while n > 1:
        n = n / 2
        passos += 1
    return passos

def meio_com_duas_barras(n):
    passos = 0
    while n > 1:
        n = n // 2
        passos += 1
    return passos

for n in [10, 20, 40]:
    print(n, dois_lacos_seguidos(n), laco_triangular(n))
print(meio_com_barra(1000), meio_com_duas_barras(1000))
print("fim")A saída começa com 10 20 45, 20 40 190 e 40 80 780, e depois 10 9 e fim. Os dois laços seguidos fazem 2n passos, que continua sendo O(n): o dois some pela segunda regra. Os laços aninhados do triângulo, em que o de dentro vai só até i, fazem n(n-1)/2 passos. É a metade do quadrado, e ainda assim é O(n²): de 20 para 40 elementos, o trabalho vai de 190 para 780, cerca de quatro vezes. E a última linha mostra uma armadilha silenciosa: com /, o n vira decimal e o laço só termina quando o valor cai abaixo de 1, o que dá 10 passos. Com //, a divisão inteira para em 1 e dá 9. A classe é a mesma, mas a contagem exata muda, e o programa não avisa.
A IA que lembra da sua vida e mora no seu computador
- Memória de longo prazo com a fonte de cada resposta
- Funciona offline: seus dados ficam no seu PC
- Lê PDFs, slides, fotos e gravações de reunião
Plano Essencial grátis para sempre
O(log n): cortar o problema ao meio
O logaritmico do primeiro exemplo merece um olhar de perto, porque a classe é a que menos se vê no cotidiano. Ele pergunta: quantas vezes posso dividir n ao meio até chegar a 1? Para 1000, a resposta foi 9. Para um milhão, 19. Para 1, nenhuma, 0.
Repare no tamanho do salto: de mil para um milhão, mil vezes mais elementos, o trabalho foi de 9 para 19 passos. Esse é o poder da busca binária. Procurar num milhão de elementos ordenados exige cerca de 20 comparações. A busca linear, no pior caso, exigiria um milhão. É a razão de a ordenação, com seu custo de O(n log n), compensar quando se vai buscar muitas vezes na lista: paga-se uma vez, e cada busca depois custa quase nada.
O logaritmo aparece sempre que um passo descarta uma fração do que resta, e não uma quantidade fixa. A base do logaritmo, 2, 10 ou outra, não importa para o Big-O, porque mudar de base só multiplica por uma constante. Nos exemplos, usa-se a divisão por 2 porque é a que os algoritmos fazem.
Quando a recursão explode: o Fibonacci
A recursão pode esconder um custo enorme sob um código curto e bonito. O exemplo clássico é o Fibonacci, em que cada número é a soma dos dois anteriores. A versão recursiva copia a definição quase palavra por palavra, e a versão em laço guarda só os dois últimos valores. As duas dão o mesmo resultado, e o programa conta o trabalho de cada uma:
chamadas = 0
def fib(n):
    global chamadas
    chamadas += 1
    if n < 2:
        return n
    return fib(n - 1) + fib(n - 2)

def fib_laco(n):
    a = 0
    b = 1
    passos = 0
    for i in range(n):
        a, b = b, a + b
        passos += 1
    return a, passos

for n in [5, 10, 15, 20]:
    chamadas = 0
    r = fib(n)
    print(n, r, "chamadas:", chamadas, "| laco:", fib_laco(n))
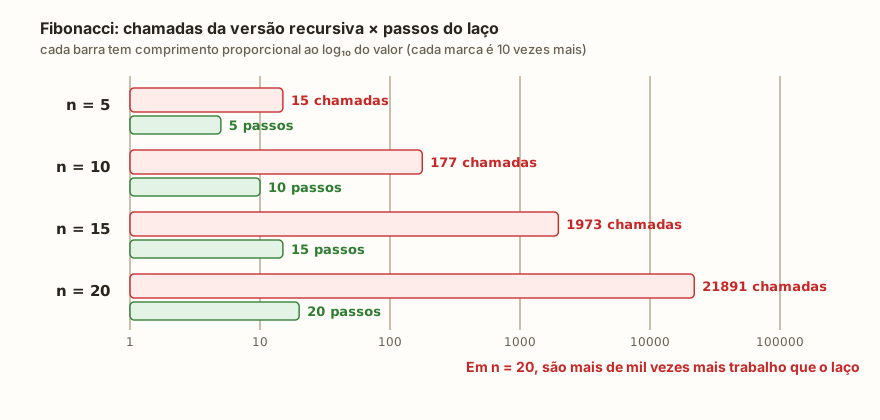
print("fim")A saída tem quatro linhas e o fim. Para n = 5, 5 5 chamadas: 15 | laco: (5, 5). Para n = 10, 10 55 chamadas: 177 | laco: (55, 10). Para 15, 15 610 chamadas: 1973 | laco: (610, 15). Para 20, 20 6765 chamadas: 21891 | laco: (6765, 20).
O resultado é o mesmo nas duas versões, mas o trabalho não. O laço dá n passos. A recursão dá 15, 177, 1973 e 21891 chamadas, e a razão entre uma linha e a seguinte fica por volta de 11: cada 5 unidades a mais em n multiplicam o trabalho por cerca de onze. Isso é crescimento exponencial. A causa é que fib(n) chama fib(n - 1) e fib(n - 2), e os dois recalculam, cada um por conta própria, quase tudo o que o outro já calculou. Para fib(30), seriam mais de 2,6 milhões de chamadas, e para fib(40), mais de 331 milhões. Esses dois totais saem da conta da fórmula, não de uma execução, porque o simulador não é lugar para rodar tanto trabalho.
A lição não é "evite a recursão". O merge sort é recursivo e é O(n log n). A lição é que a forma do código não diz o custo: é preciso contar quantas vezes cada pedaço roda. No Fibonacci, o desperdício vem de recalcular os mesmos valores, e a cura é guardar o que já foi calculado, seja num laço, seja num dicionário usado como memória.
O mesmo problema com três custos
Veja como a escolha do algoritmo muda a classe de um mesmo problema: descobrir se uma lista tem valores repetidos. Três jeitos, cada um contando seus passos:
def duplicados_quadratico(lista):
    comparacoes = 0
    for i in range(len(lista)):
        for j in range(i + 1, len(lista)):
            comparacoes += 1
            if lista[i] == lista[j]:
                return True, comparacoes
    return False, comparacoes

def duplicados_ordenando(lista):
    copia = sorted(lista)
    comparacoes = 0
    for i in range(1, len(copia)):
        comparacoes += 1
        if copia[i] == copia[i - 1]:
            return True, comparacoes
    return False, comparacoes

def duplicados_conjunto(lista):
    vistos = set()
    passos = 0
    for v in lista:
        passos += 1
        if v in vistos:
            return True, passos
        vistos.add(v)
    return False, passos

for n in [10, 100]:
    sem = list(range(n))
    print(n, "sem repetidos:", duplicados_quadratico(sem), duplicados_ordenando(sem), duplicados_conjunto(sem))
com = [3, 8, 1, 9, 4, 8, 2]
print(duplicados_quadratico(com), duplicados_ordenando(com), duplicados_conjunto(com))
print("fim")A saída tem três linhas e o fim. A primeira, para 10 elementos sem repetição, é 10 sem repetidos: (False, 45) (False, 9) (False, 10). A segunda, para 100, é 100 sem repetidos: (False, 4950) (False, 99) (False, 100). A terceira, com repetido, é (True, 10) (True, 5) (True, 6).
Os três respondem certo, mas com custos diferentes. O primeiro compara todos os pares: 45 comparações com 10 elementos e 4950 com 100. É O(n²), como o laço triangular do exemplo anterior. O segundo ordena primeiro, e depois os repetidos ficam lado a lado, de modo que basta comparar cada elemento com o anterior, 9 e 99 comparações. Mas essas contagens não incluem a ordenação, que custa O(n log n). O custo total do método é o da ordenação, porque ela domina o das comparações. O terceiro usa um conjunto: para cada valor, pergunta se já foi visto, e a pergunta v in vistos custa O(1) em média. São 10 e 100 passos, O(n).
O terceiro parece o vencedor, e na maioria dos casos é, mas ele traz um custo que a contagem de passos não mostra: o conjunto guarda uma cópia dos valores, e isso gasta memória. Na ESP32, com pouca memória, trocar tempo por espaço nem sempre é um bom negócio. O primeiro método quase não gasta memória além da lista. Isso é comum: raramente existe algoritmo que ganhe em tudo, e escolher é equilibrar tempo, memória e simplicidade.
Repare também no caso da lista com, com o 8 repetido: os métodos pararam cedo, depois de 10, 5 e 6 passos. Esse é o melhor caso, quando a resposta aparece antes do fim. O Big-O costuma falar do pior caso, que é o de lista sem repetidos, porque é ele que garante um limite de espera. É o que se mede na tabela de contagens com 10 e 100 elementos.
O custo escondido dentro de um comando
A contagem de laços engana quando um comando de uma linha esconde um laço. O exemplo mais comum é o in aplicado a uma lista: x in lista parece uma pergunta, mas por baixo é uma busca linear, O(n). Dentro de um laço, ele vira O(n²) sem que o código mostre dois laços:
def contem(lista, x):
    global comparacoes
    for v in lista:
        comparacoes += 1
        if v == x:
            return True
    return False
comparacoes = 0
def sem_repetidos_lista(dados):
    global comparacoes
    resultado = []
    for x in dados:
        if not contem(resultado, x):
            resultado.append(x)
    return resultado
for n in [10, 100]:
    comparacoes = 0
    r = sem_repetidos_lista(list(range(n)))
    print(n, len(r), comparacoes)
dados = [3, 1, 3, 2, 1]
comparacoes = 0
print(sem_repetidos_lista(dados), comparacoes, sorted(set(dados)))
print("fim")A saída é 10 10 45, 100 100 4950, [3, 1, 2] 6 [1, 2, 3] e fim. A função contem faz o papel do in e conta as comparações, para o trabalho escondido ficar à vista. Com 10 elementos sem repetição, foram 45 comparações, e com 100, 4950: os mesmos números do método quadrático da seção anterior, só que agora dentro de uma função que, à primeira vista, tem um laço só. A última linha mostra que a função mantém a ordem da primeira aparição ([3, 1, 2]), enquanto sorted(set(dados)) devolve os valores ordenados.
Outros comandos que escondem um laço são sum, max, min, lista.index(x), lista.count(x), lista.remove(x) e o fatiamento lista[a:b], que copia os elementos. Todos custam O(n), e dentro de um laço sobre a mesma lista pesam como um segundo laço. Já o in de um conjunto ou de um dicionário custa O(1) em média, e é por isso que o terceiro método da seção anterior ficou linear.
O exemplo a seguir junta tudo numa situação real da ESP32: a média móvel das últimas leituras de um sensor. A versão ingênua refaz a soma da janela inteira a cada leitura. A esperta mantém a soma e só atualiza as pontas: soma o valor novo e tira o que saiu da janela.
leituras = [20, 22, 21, 25, 30, 28, 27, 26, 24, 23]
janela = 4

def media_movel_refazendo(dados, k):
    medias = []
    somas = 0
    for i in range(k - 1, len(dados)):
        s = 0
        for j in range(i - k + 1, i + 1):
            s += dados[j]
            somas += 1
        medias.append(s / k)
    return medias, somas

def media_movel_acumulando(dados, k):
    medias = []
    operacoes = 0
    s = 0
    for i in range(len(dados)):
        s += dados[i]
        operacoes += 1
        if i >= k:
            s -= dados[i - k]
            operacoes += 1
        if i >= k - 1:
            medias.append(s / k)
    return medias, operacoes

m1, c1 = media_movel_refazendo(leituras, janela)
m2, c2 = media_movel_acumulando(leituras, janela)
print(m1)
print(m2)
print(m1 == m2, c1, c2)
grandes = list(range(100))
print(media_movel_refazendo(grandes, 10)[1], media_movel_acumulando(grandes, 10)[1])
print(media_movel_refazendo(grandes, 50)[1], media_movel_acumulando(grandes, 50)[1])
print("fim")A saída começa com as duas listas de médias, iguais: [22.0, 24.5, 26.0, 27.5, 27.75, 26.25, 25.0]. Depois vem True 28 16, as somas feitas pelos dois métodos nas 10 leituras. Depois 910 190, para 100 leituras e janela de 10, e 2550 150, para janela de 50, e o fim.
As duas versões dão a mesma resposta, e é essa a graça: o mesmo problema, o mesmo resultado, e custos muito diferentes. A versão que refaz a soma faz (n - k + 1) * k somas, que cresce com o tamanho da janela: 910 com janela 10 e 2550 com janela 50. A que acumula faz cerca de 2n operações, quase sempre as mesmas, 190 e 150, porque a janela maior não pesa. A primeira é O(n * k), e a segunda é O(n). Numa placa que lê um sensor várias vezes por segundo, a diferença decide se o programa dá conta do recado.
Os algoritmos desta parte
Com a notação à mão, os algoritmos dos artigos anteriores se resumem numa tabela. As colunas separam o melhor e o pior caso, porque vários algoritmos se comportam de modo diferente conforme a entrada:
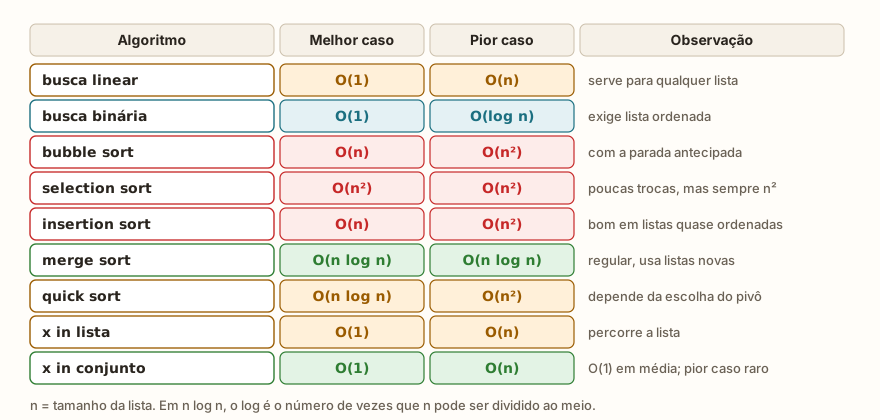
Alguns pontos para ler a tabela com cuidado:
- A busca linear acha de primeira se o valor está no começo,
O(1), e percorre tudo se está no fim ou não existe,O(n). - A busca binária é
O(log n), mas só funciona numa lista ordenada. Ordenar custaO(n log n), então ela só compensa quando se busca várias vezes. - O bubble sort com parada antecipada faz
O(n)numa lista já ordenada, uma passada só. O selection sort não tem essa saída: faz as mesmas comparações em qualquer lista, e o que ele economiza são as trocas. - O insertion sort também é
O(n)quando a lista já está quase em ordem. Por isso o artigo sobre ele o recomenda para listas pequenas e quase ordenadas. - O merge sort mantém
O(n log n)em qualquer entrada, mas cria listas novas. No artigo anterior, uma lista invertida de 1000 elementos pediu 5044 comparações no merge sort, contra 499500 do insertion sort, esse segundo valor calculado pela fórmula. - O quick sort é
O(n log n)na média, mas cai paraO(n²)no pior caso, quando o pivô escolhido é sempre o menor ou o maior elemento.
A tabela também lembra uma verdade desconfortável: para listas pequenas, tudo é rápido. A diferença entre as classes só aparece quando n cresce. Se a sua lista tem 20 elementos e nunca vai passar disso, o algoritmo mais simples de entender é, muitas vezes, o melhor.
O que o Big-O não diz
A notação é uma ferramenta, não um veredito, e vale conhecer seus limites:
- Não mede o tempo real. Dois algoritmos
O(n)podem diferir em dez vezes, porque o Big-O joga fora as constantes. O cronômetro na própria placa é que dá a resposta final. - Não mede a memória. O método do conjunto ganhou em tempo e perdeu em espaço. Existe uma complexidade de espaço, escrita com a mesma notação, e na ESP32 ela importa tanto quanto a de tempo.
- Não vale para
npequeno. Constantes e termos menores, que a notação ignora, decidem quandoné pequeno. - Depende da entrada. Por isso existem o melhor, o médio e o pior caso, e é preciso saber de qual se está falando.
- Depende do que se conta. Contar comparações, trocas ou chamadas dá números diferentes, e todos são válidos desde que se diga qual foi a escolha.
Na ESP32: onde isso pesa
Num programa de sensores, o n quase nunca é grande, mas o laço principal roda para sempre. Uma função O(n²) sobre 50 leituras faz 2500 passos, e se rodar a cada ciclo, o programa passa o tempo todo nela. Três situações em que a conta compensa:
- Média ou filtro das últimas leituras. Como na média móvel acima, refazer a soma a cada leitura custa
O(n * k). Manter a soma custaO(n). - Buscar numa tabela de calibração. Se a tabela é consultada o tempo todo, guardá-la ordenada e usar a busca binária, ou em um dicionário, custa muito menos que percorrê-la a cada consulta.
- Guardar um histórico. Uma lista que só cresce acaba com a memória da placa. Limitar o tamanho, descartando o mais antigo, é uma decisão de espaço que o Big-O de tempo não enxerga.
Em todos esses casos, o caminho é o mesmo do artigo: contar os passos, olhar como a conta cresce, e só depois, se a dúvida persistir, medir na placa com time.ticks_ms().
Erros comuns
Confundir dois laços com O(n²). Dois laços seguidos somam, O(n + n), e continuam O(n). Só os aninhados multiplicam. Antes de escrever O(n²), confira se um laço está mesmo dentro do outro e se os dois percorrem o tamanho da entrada.
Esquecer o laço escondido. x in lista, max, sum e o fatiamento são laços. Contar só os for e while que aparecem no código dá uma classe menor do que a verdadeira.
Deixar de contar a ordenação. Quando um método começa com sorted(lista), o custo dele é pelo menos o da ordenação, e não o do laço que vem depois. No computador, o sorted() é O(n log n).
Confundir melhor caso com caso comum. Um algoritmo que parou cedo na lista de teste pode precisar da lista inteira em outra. Teste sempre o pior caso, como a lista sem repetidos ou o valor que não existe.
Medir só com n pequeno. Com 10 elementos, O(n²) e O(n) parecem iguais. Compare contagens com n, 2n e 4n, como nos exemplos, e veja o que acontece quando dobra.
Contar sem dizer o quê. Uma contagem de "passos" que mistura comparações e atribuições não tem significado. Escolha uma operação e conte só ela.
O que costuma aparecer em sala
São padrões que se repetem com quem aprende esse assunto. Não são relato de uma turma específica.
Achar que Big-O é uma medida de segundos. A pessoa pergunta "quantos segundos é O(n)?". A notação não responde isso, só diz como o trabalho cresce. A contagem de passos, antes do cronômetro, ajuda a separar as duas ideias.
Decorar a tabela sem saber contar. Quem memoriza "busca binária é log n" mas não consegue contar os passos de um laço pequeno trava na primeira função diferente. Contar à mão, para n = 4 e n = 8, e conferir no simulador ensina mais que a tabela.
Achar que menos linhas é mais rápido. Uma linha com x in lista dentro de um laço parece mais enxuta que dois laços, e custa o mesmo. O tamanho do código não diz nada sobre o custo.
Ignorar o laço dentro do comando. A pergunta que ajuda é: o que este comando faz por baixo? Se a resposta é "percorre a lista", é um laço.
Querer a classe mais baixa em tudo. Reescrever um programa de 20 elementos para ganhar uma classe só complica o código. A pergunta certa é se o n vai crescer.
Exercício: contar passos com a entrada do usuário
Escreva um programa que leia um tamanho n, conte os passos de um laço simples e de dois laços aninhados, e mostre os dois totais. Em seguida, peça outro n e repita só os dois laços, para ver o efeito de dobrar. Use entradas de 6 e 12 no simulador, que é o que o bloco abaixo faz:
n = int(input("Quantos elementos? "))
passos_um = 0
for i in range(n):
    passos_um += 1
passos_dois = 0
for i in range(n):
    for j in range(n):
        passos_dois += 1
print("n =", n)
print("um laco:", passos_um)
print("dois lacos:", passos_dois)
n = int(input("E agora? "))
passos_dois = 0
for i in range(n):
    for j in range(n):
        passos_dois += 1
print("n =", n, "dois lacos:", passos_dois)
print("fim")O simulador mostra cada pergunta seguida do valor digitado, de modo que a saída começa com Quantos elementos? 6. Depois vêm n = 6, um laco: 6, dois lacos: 36, E agora? 12, n = 12 dois lacos: 144 e fim. Repare: o n dobrou de 6 para 12, e os passos do laço duplo foram de 36 para 144, quatro vezes mais, como a tabela do início previa.
Para treinar, tente: trocar o laço duplo por um triangular e conferir a fórmula n(n-1)/2; acrescentar um terceiro laço aninhado e ver a classe passar a O(n³); contar os passos de um while que divide n por 2; e escrever uma função que conte as comparações da busca linear no pior caso.
Perguntas frequentes
O que significa o O em Big-O? É a letra de "ordem": a ordem de grandeza do crescimento do trabalho. O(n²) se lê "O de n ao quadrado".
Qual a diferença entre O(n) e O(n log n)? O segundo cresce um pouco mais rápido. Para um milhão de elementos, n log n é cerca de 20 milhões, contra um milhão de n. Para listas pequenas, quase não se nota.
O(1) quer dizer um passo só? Quer dizer que o número de passos não depende de n. Pode ser um, dois ou dez, desde que não cresça junto com a entrada.
A base do logaritmo importa? Para o Big-O, não. Mudar de base multiplica por uma constante, e as constantes não contam.
Por que o Big-O fala do pior caso? Porque ele dá uma garantia: o algoritmo nunca vai demorar mais que isso. O melhor caso é otimista demais para planejar o tempo de um programa.
Existe Big-O para memória? Existe, e se chama complexidade de espaço. O método do conjunto, por exemplo, gasta O(n) de espaço a mais para ganhar tempo.
O sorted() do MicroPython tem o mesmo custo do Python do computador? No computador, o sorted() é O(n log n). A implementação do MicroPython é outra, como já apareceu na estabilidade, e este artigo não afirma o custo exato dela.
Preciso saber Big-O para programar a ESP32? Para os primeiros projetos, não. Mas ele evita o susto de um programa que funciona bem com 10 leituras e trava com 1000.
Para continuar
Os desafios Busca na Lista, Maior da Lista e Média da Lista são bons para contar passos: resolva cada um e diga qual é a classe da sua solução. Para rever a base, passe pelos artigos sobre busca linear e binária, bubble e selection sort, insertion sort, merge sort e quick sort, recursividade e conjuntos, e pela trilha de lógica.
O próximo artigo abre uma nova parte da série, sobre objetos, erros e boas práticas, com as classes e os objetos: como juntar dados e funções numa coisa só, com atributos, métodos e o __init__, e como isso organiza um programa que cresce.