Fundamentos
Merge sort e quick sort em Python: dividir para conquistar
Entenda como o merge sort e o quick sort ordenam dividindo a lista, escreva os dois com recursão, compare o custo e conheça o limite de recursão do simulador.
Por Prof. Rodrigo Faustino · Atualizado em · 16 min de leitura
Os algoritmos do artigo anterior, bubble, selection e insertion, têm em comum um limite: o trabalho cresce com o quadrado do tamanho da lista. Para 100 elementos, são cerca de 5 mil comparações. Para mil, quase meio milhão. Existe uma ideia mais esperta para listas maiores, que vale em toda a computação: dividir para conquistar. Em vez de atacar a lista inteira, divide-se o problema em partes menores, resolve-se cada parte do mesmo jeito, e junta-se o resultado.
Dois algoritmos clássicos de ordenação seguem essa ideia, e os dois usam recursão. O merge sort divide a lista ao meio sem pensar, ordena as duas metades e depois as mescla. O quick sort escolhe um elemento, o pivô, separa os menores de um lado e os maiores do outro, e ordena cada lado. O primeiro faz o trabalho na hora de juntar, e o segundo, na hora de dividir. Este artigo escreve os dois, mede o custo e mostra um limite do simulador, que imita o da placa, que pesa mais nesses algoritmos do que nos anteriores. Todos os exemplos rodaram no simulador, e os resultados citados são os que ele produz.
Merge sort: dividir ao meio, juntar em ordem
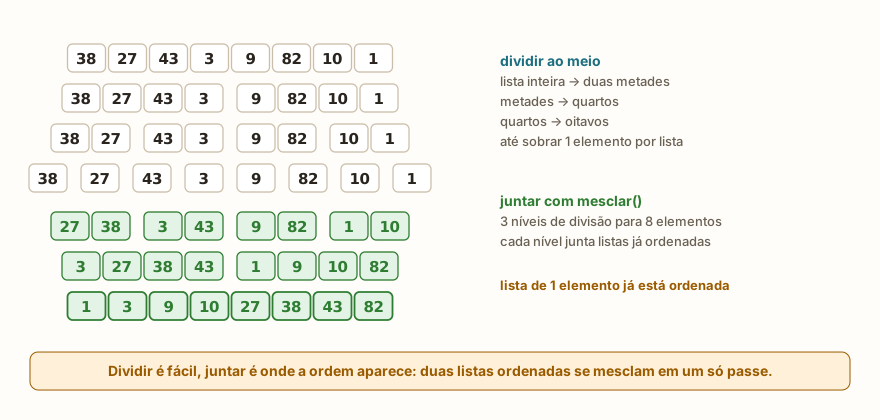
O merge sort se apoia numa operação simples: pegar duas listas já ordenadas e juntá-las numa só, também ordenada. Como cada uma já está em ordem, basta olhar a frente das duas, pegar a menor e avançar naquela lista. É a mesclagem, e o resto do algoritmo é só dividir a lista até que cada pedaço tenha um elemento, o que garante que a mesclagem sempre receba listas ordenadas.
def mesclar(a, b):
    resultado = []
    i = 0
    j = 0
    while i < len(a) and j < len(b):
        if a[i] <= b[j]:
            resultado.append(a[i])
            i += 1
        else:
            resultado.append(b[j])
            j += 1
    resultado.extend(a[i:])
    resultado.extend(b[j:])
    return resultado

print(mesclar([1, 4, 7], [2, 3, 9, 10]))
print(mesclar([], [1, 2]), mesclar([5], []), mesclar([], []), mesclar([2, 2], [2]))

def merge_sort(lista):
    if len(lista) <= 1:
        return lista
    meio = len(lista) // 2
    esquerda = merge_sort(lista[:meio])
    direita = merge_sort(lista[meio:])
    return mesclar(esquerda, direita)

print(merge_sort([38, 27, 43, 3, 9, 82, 10]))
print(merge_sort([3, 3, 1]), merge_sort([]), merge_sort([7]), merge_sort([1, 2, 3]))
original = [5, 2, 4, 1]
print(merge_sort(original), original)

def merge_sort_trace(lista, nivel=0):
    print("  " * nivel + "dividir", lista)
    if len(lista) <= 1:
        return lista
    meio = len(lista) // 2
    esq = merge_sort_trace(lista[:meio], nivel + 1)
    dir = merge_sort_trace(lista[meio:], nivel + 1)
    r = mesclar(esq, dir)
    print("  " * nivel + "juntar", r)
    return r
merge_sort_trace([38, 27, 43, 3])
print("fim")A saída começa com [1, 2, 3, 4, 7, 9, 10] e [1, 2] [5] [] [2, 2, 2]. Depois vêm [3, 9, 10, 27, 38, 43, 82], [1, 3, 3] [] [7] [1, 2, 3] e [1, 2, 4, 5] [5, 2, 4, 1]. O rastro da última função é:
dividir [38, 27, 43, 3]
  dividir [38, 27]
    dividir [38]
    dividir [27]
  juntar [27, 38]
  dividir [43, 3]
    dividir [43]
    dividir [3]
  juntar [3, 43]
juntar [3, 27, 38, 43]E por fim fim.
A função mesclar usa dois índices, i para a lista a e j para a b, como dois dedos correndo sobre duas filas ordenadas. Enquanto os dois dedos estão dentro das listas, compara-se a[i] com b[j], o menor vai para o resultado, e o dedo daquela lista avança. Quando uma das listas acaba, sobra o resto da outra, que já está em ordem e só precisa ser copiado: é o que fazem as duas linhas com extend, a[i:] e b[j:]. Uma das duas fatias é sempre vazia. A comparação usa <=, e não <, para que, em caso de empate, o elemento da lista da esquerda saia primeiro, o que mantém a ordenação estável.
A segunda linha de testes mostra os casos de borda: uma lista vazia, as duas vazias, e valores repetidos. Todos funcionam.
A função merge_sort é curta, e cada linha tem um papel:
if len(lista) <= 1: return listaé o caso base da recursão. Uma lista com zero ou um elemento já está ordenada, e não há mais o que dividir.meio = len(lista) // 2acha o ponto de corte.merge_sort(lista[:meio])emerge_sort(lista[meio:])ordenam cada metade, chamando a si mesma com uma lista menor. Cada chamada divide de novo, até chegar às listas de um elemento.return mesclar(esquerda, direita)junta as duas metades, que já voltam ordenadas.
O rastro com recuos mostra a ordem em que as coisas acontecem. A lista [38, 27, 43, 3] é dividida em [38, 27] e [43, 3], cada uma em dois elementos soltos. Só quando se chega às listas de um elemento é que o trabalho de juntar começa: [38] com [27] dá [27, 38], [43] com [3] dá [3, 43], e, por fim, as duas dão [3, 27, 38, 43]. Repare que o print("juntar") só aparece depois das chamadas filhas terminarem, o que é a recursão em ação.
Um detalhe importante: o merge sort não altera a lista original. As fatias lista[:meio] e lista[meio:] criam listas novas, e o resultado é uma lista nova. Por isso original continua [5, 2, 4, 1] depois da ordenação. É o oposto do sort() das listas, que altera no lugar.
Da ementa ao semestre planejado
- Plano de ensino e calendário montados sozinhos
- Diário de aulas pronto para colar no SIGA
- Slides e listas de exercícios com gabarito
Versão Community grátis · Windows
Quick sort: escolher um pivô
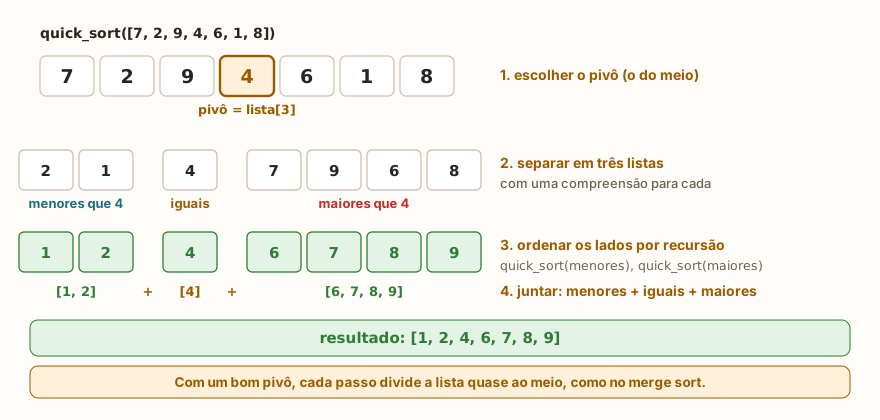
O quick sort faz o contrário do merge sort: a parte difícil é dividir, e juntar é só concatenar. Escolhe-se um elemento, o pivô, e separam-se todos os outros em três grupos: os menores que o pivô, os iguais e os maiores. O pivô e seus iguais já estão no lugar certo. Basta ordenar, do mesmo jeito, o grupo dos menores e o dos maiores, e juntar tudo na ordem menores + iguais + maiores.
lista = [7, 2, 9, 4, 6, 1, 8]
pivo = lista[len(lista) // 2]
menores = [x for x in lista if x < pivo]
iguais = [x for x in lista if x == pivo]
maiores = [x for x in lista if x > pivo]
print(pivo, menores, iguais, maiores)
def quick_sort(lista):
    if len(lista) <= 1:
        return lista
    pivo = lista[len(lista) // 2]
    menores = [x for x in lista if x < pivo]
    iguais = [x for x in lista if x == pivo]
    maiores = [x for x in lista if x > pivo]
    return quick_sort(menores) + iguais + quick_sort(maiores)
print(quick_sort(menores), quick_sort(maiores), quick_sort(lista))
print("fim")A saída é 4 [2, 1] [4] [7, 9, 6, 8], depois [1, 2] [6, 7, 8, 9] [1, 2, 4, 6, 7, 8, 9] e por fim fim. É exatamente o que a figura mostra: o pivô é o 4, o elemento do meio, os menores são [2, 1], os maiores são [7, 9, 6, 8], e cada lado se ordena sozinho.
A versão com compreensões é a mais legível, e basta uma função de poucas linhas:
def quick_sort(lista):
    if len(lista) <= 1:
        return lista
    pivo = lista[len(lista) // 2]
    menores = [x for x in lista if x < pivo]
    iguais = [x for x in lista if x == pivo]
    maiores = [x for x in lista if x > pivo]
    return quick_sort(menores) + iguais + quick_sort(maiores)

print(quick_sort([38, 27, 43, 3, 9, 82, 10]))
print(quick_sort([3, 3, 1]), quick_sort([]), quick_sort([7]), quick_sort([1, 2, 3]), quick_sort([5, 5, 5]))
original = [5, 2, 4, 1]
print(quick_sort(original), original)

def quick_trace(lista, nivel=0):
    if len(lista) <= 1:
        print("  " * nivel + "pronto", lista)
        return lista
    pivo = lista[len(lista) // 2]
    menores = [x for x in lista if x < pivo]
    iguais = [x for x in lista if x == pivo]
    maiores = [x for x in lista if x > pivo]
    print("  " * nivel + "pivo", pivo, "menores", menores, "iguais", iguais, "maiores", maiores)
    return quick_trace(menores, nivel + 1) + iguais + quick_trace(maiores, nivel + 1)
quick_trace([38, 27, 43, 3, 9, 82, 10])

def particionar(lista, baixo, alto):
    pivo = lista[alto]
    i = baixo
    for j in range(baixo, alto):
        if lista[j] < pivo:
            lista[i], lista[j] = lista[j], lista[i]
            i += 1
    lista[i], lista[alto] = lista[alto], lista[i]
    return i

def quick_no_lugar(lista, baixo, alto):
    if baixo < alto:
        p = particionar(lista, baixo, alto)
        quick_no_lugar(lista, baixo, p - 1)
        quick_no_lugar(lista, p + 1, alto)

dados = [38, 27, 43, 3, 9, 82, 10]
quick_no_lugar(dados, 0, len(dados) - 1)
print(dados)
print("fim")A saída começa com [3, 9, 10, 27, 38, 43, 82], depois [1, 3, 3] [] [7] [1, 2, 3] [5, 5, 5] e [1, 2, 4, 5] [5, 2, 4, 1]. O rastro do quick_trace é:
pivo 3 menores [] iguais [3] maiores [38, 27, 43, 9, 82, 10]
  pronto []
  pivo 9 menores [] iguais [9] maiores [38, 27, 43, 82, 10]
    pronto []
    pivo 43 menores [38, 27, 10] iguais [43] maiores [82]
      pivo 27 menores [10] iguais [27] maiores [38]
        pronto [10]
        pronto [38]
pronto [82]Depois vêm [3, 9, 10, 27, 38, 43, 82] da versão no lugar e fim.
A função quick_sort tem o mesmo desenho do merge sort: o caso base é a lista com no máximo um elemento, e o passo recursivo chama a função para os dois lados. A diferença é que aqui a lista não é cortada pelo meio da posição, e sim pelo valor do pivô. O uso de três listas, com iguais à parte, é o que faz a função lidar bem com valores repetidos, como [5, 5, 5], e evita um erro silencioso que veremos adiante.
O rastro tem uma lição. Na primeira chamada, o elemento do meio é o 3, que por acaso é o menor valor da lista. A lista dos menores fica vazia, e a dos maiores tem quase tudo, seis elementos de sete. A divisão foi desigual: pouco ganho. Na chamada seguinte acontece de novo, com o pivô 9. Só depois a divisão fica razoável. Quando o pivô cai perto do meio dos valores, as duas metades têm tamanhos parecidos e o algoritmo é rápido. Quando cai perto de uma ponta, cada passo remove só um ou dois elementos, e o algoritmo vira, na prática, tão lento quanto os simples. A escolha do pivô é, portanto, a decisão central do quick sort.
A versão quick_no_lugar mostra a variante clássica, que ordena a própria lista sem criar listas novas. A função particionar usa o último elemento como pivô e reorganiza o trecho de baixo a alto de modo que os menores fiquem à esquerda, o pivô no meio e os maiores à direita. A variável i marca onde vai o próximo "menor". Ao fim, o pivô é trocado para a posição i, que é a sua posição definitiva, e a função devolve essa posição. A recursão então ordena os dois trechos, sem incluir o pivô. É mais econômica em memória, mas exige cuidado com os índices.
Quanto custam
comparacoes = 0
def mesclar(a, b):
    global comparacoes
    resultado = []
    i = 0
    j = 0
    while i < len(a) and j < len(b):
        comparacoes += 1
        if a[i] <= b[j]:
            resultado.append(a[i])
            i += 1
        else:
            resultado.append(b[j])
            j += 1
    resultado.extend(a[i:])
    resultado.extend(b[j:])
    return resultado
def merge_sort(lista):
    if len(lista) <= 1:
        return lista
    meio = len(lista) // 2
    return mesclar(merge_sort(lista[:meio]), merge_sort(lista[meio:]))
def insertion_comparacoes(lista):
    c = 0
    for i in range(1, len(lista)):
        chave = lista[i]
        j = i - 1
        while j >= 0:
            c += 1
            if lista[j] > chave:
                lista[j + 1] = lista[j]
                j -= 1
            else:
                break
        lista[j + 1] = chave
    return c
for n in [8, 16, 100, 1000]:
    inv = list(range(n, 0, -1))
    ord_ = list(range(1, n + 1))
    comparacoes = 0
    r1 = merge_sort(inv)
    ci = comparacoes
    comparacoes = 0
    r2 = merge_sort(ord_)
    co = comparacoes
    print(n, "merge invertida", ci, "ordenada", co, "| insertion invertida", insertion_comparacoes(inv[:]) if n <= 100 else "-")
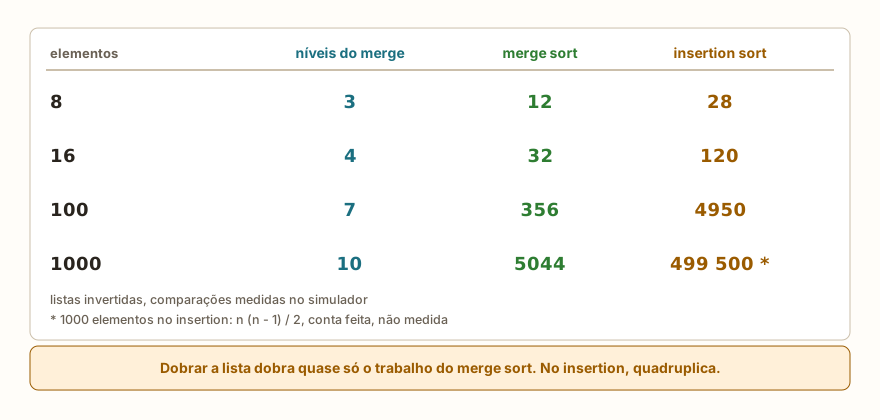
print("fim")A saída tem quatro linhas: 8 merge invertida 12 ordenada 12 | insertion invertida 28, 16 merge invertida 32 ordenada 32 | insertion invertida 120, 100 merge invertida 356 ordenada 316 | insertion invertida 4950 e 1000 merge invertida 5044 ordenada 4932 | insertion invertida -, seguidas de fim. Para 1000 elementos, o insertion não foi medido, e o - marca isso. A conta pela fórmula, n * (n - 1) / 2, dá 499 500 comparações, cerca de cem vezes mais do que as 5044 do merge sort.
O merge sort tem um comportamento muito regular. Há log2(n) níveis de divisão, aproximadamente: 3 para 8 elementos, 4 para 16, 7 para 100 e 10 para 1000. Em cada nível, a mesclagem passa por todos os elementos uma vez, o que dá algo próximo de n comparações por nível. O total fica na ordem de n * log2(n): para 100 elementos, esse produto dá cerca de 660, e as 356 comparações medidas ficam abaixo disso. A ordem inicial da lista quase não importa para o merge sort: 356 contra 316 comparações para a lista invertida e a ordenada.
Comparar com o insertion mostra o ganho. Com 8 elementos, a diferença é pequena, 12 contra 28. Com 100, são 356 contra 4950. A cada vez que a lista dobra, o merge sort faz um pouco mais que o dobro do trabalho, e o insertion quadruplica. Essa diferença de ritmo é o assunto do próximo artigo, sobre complexidade de algoritmos.
O quick sort tem custo parecido quando o pivô divide bem, e o mesmo comportamento quadrático dos algoritmos simples quando divide mal. Como o resultado depende da lista e do pivô, não vamos tabelar números para ele aqui. A próxima seção mostra o problema na prática.
O limite de recursão e o pior caso do quick sort
O artigo sobre recursividade mostrou que o MicroPython tem um limite de recursão muito menor que o do Python de computador, e que o simulador reproduz isso: em torno de 50 chamadas aninhadas. Para o merge sort, isso não é problema, porque a profundidade é log2(n): com mil elementos, 10 níveis. Para o quick sort, depende do pivô:
def quick_sort_primeiro(lista):
    if len(lista) <= 1:
        return lista
    pivo = lista[0]
    menores = [x for x in lista[1:] if x < pivo]
    maiores = [x for x in lista[1:] if x >= pivo]
    return quick_sort_primeiro(menores) + [pivo] + quick_sort_primeiro(maiores)
ultimo = 0
for n in range(40, 70):
    try:
        quick_sort_primeiro(list(range(n)))
        ultimo = n
    except RuntimeError:
        print("primeiro erro em n =", n, "ultimo ok =", ultimo)
        break
print("fim")A saída é primeiro erro em n = 51 ultimo ok = 50 e fim.
Esta versão usa o primeiro elemento como pivô, e o teste é com listas já ordenadas, de 40 a 69 elementos. Numa lista ordenada, o primeiro elemento é sempre o menor: a lista dos menores fica vazia, e a dos maiores contém todo o resto. Cada chamada tira um elemento, e a profundidade da recursão vira n. No simulador, a lista de 50 elementos passa, e a de 51 estoura o limite com RuntimeError, como a saída mostra. No Python de computador, o limite padrão é de cerca de mil chamadas, e uma lista de 100 elementos passa sem erro.
Isso mostra duas coisas. Primeiro, o pior caso do quick sort não é teoria: é uma lista ordenada com o pivô na ponta, justamente a lista mais comum de se receber. Segundo, na ESP32 o limite de recursão torna esse pior caso muito mais perto do que no computador. Com o pivô no meio, como na versão das compreensões, a lista ordenada é o melhor caso, porque o elemento do meio divide a lista em duas partes iguais. Por isso o quick_sort anterior ordena sem problemas uma lista invertida de mil elementos, e o merge sort também, com 10 níveis.
Quem precisa de segurança escolhe um pivô melhor, como o do meio, ou o mediano de três (o valor do meio entre o primeiro, o do centro e o último). Mas o ponto de partida mais simples é este: para listas pequenas e ordenações comuns, use sorted(). Os dois algoritmos deste artigo são para entender a ideia.
A IA que lembra da sua vida e mora no seu computador
- Memória de longo prazo com a fonte de cada resposta
- Funciona offline: seus dados ficam no seu PC
- Lê PDFs, slides, fotos e gravações de reunião
Plano Essencial grátis para sempre
Na ESP32: juntar dois registros ordenados por tempo
Mesclar duas listas ordenadas é uma operação útil por si só, sem precisar do merge sort inteiro. Imagine dois sensores que registram leituras com o instante de cada uma, cada um com a sua lista já em ordem de tempo, e um programa que precisa de um registro só, em ordem cronológica:
def mesclar(a, b):
    resultado = []
    i = 0
    j = 0
    while i < len(a) and j < len(b):
        if a[i][0] <= b[j][0]:
            resultado.append(a[i])
            i += 1
        else:
            resultado.append(b[j])
            j += 1
    resultado.extend(a[i:])
    resultado.extend(b[j:])
    return resultado
sensor_a = [(1, "A:21.5"), (4, "A:21.7"), (7, "A:22.0")]
sensor_b = [(2, "B:55%"), (3, "B:56%"), (9, "B:54%")]
for t, msg in mesclar(sensor_a, sensor_b):
    print(t, msg)
log = mesclar(sensor_a, [(4, "B:58%")])
print(log)
print("fim")A saída é 1 A:21.5, 2 B:55%, 3 B:56%, 4 A:21.7, 7 A:22.0, 9 B:54%, depois [(1, 'A:21.5'), (4, 'A:21.7'), (4, 'B:58%'), (7, 'A:22.0')] e fim.
A função é a mesma, com uma mudança: cada item é uma tupla (instante, mensagem), e a comparação olha o primeiro campo, a[i][0] contra b[j][0]. O resultado é o registro dos dois sensores intercalado por tempo. O último teste mostra o desempate: quando dois registros têm o mesmo instante, 4, o da lista a sai primeiro, graças ao <=. O mesmo vale para juntar registros de arquivos, de duas tarefas ou de duas fontes de eventos. Os sensores usados nos artigos de DHT22, HC-SR04 e PIR são exemplos de fontes que podem gerar esses registros.
Há uma ressalva sobre memória. O merge sort e a versão do quick sort com compreensões criam listas novas a cada divisão, e a memória de uma placa é pequena. Para listas de dezenas de itens, isso não pesa. Para centenas ou milhares, convém pensar na versão no lugar, ou simplesmente em sorted().
Erros comuns
O primeiro é esquecer o caso base:
def merge_sort(lista):
    meio = len(lista) // 2
    return merge_sort(lista[:meio]) + merge_sort(lista[meio:])
print(merge_sort([3, 1, 2]))RuntimeError: maximum recursion depth exceededAntes dessa linha, o simulador imprime cerca de 50 linhas repetidas de File "main.py", line 3, in merge_sort. A função divide e chama a si mesma sem nunca parar: uma lista de um elemento vira uma lista vazia, que vira outra lista vazia, para sempre. No Python de computador, a mensagem é RecursionError: maximum recursion depth exceeded while calling a Python object. A correção é o if len(lista) <= 1: return lista.
O segundo é um laço de mesclagem sem a condição de parada:
def mesclar(a, b):
    resultado = []
    i = j = 0
    while True:
        if a[i] <= b[j]:
            resultado.append(a[i]); i += 1
        else:
            resultado.append(b[j]); j += 1
    return resultado
print(mesclar([1], [2]))IndexError: list index out of rangeCom while True, os índices crescem até passar do fim de uma das listas, e o programa falha. A condição correta é while i < len(a) and j < len(b), seguida do extend com o que sobrou.
Armadilhas silenciosas
Os erros mais perigosos dos dois algoritmos são os que não dão mensagem:
def quick_sort_ruim(lista):
    if len(lista) <= 1:
        return lista
    pivo = lista[0]
    menores = [x for x in lista if x < pivo]
    maiores = [x for x in lista if x > pivo]
    return quick_sort_ruim(menores) + [pivo] + quick_sort_ruim(maiores)
print(quick_sort_ruim([3, 1, 3, 2, 3]))
def mesclar(a, b):
    r = []
    i = j = 0
    while i < len(a) and j < len(b):
        if a[i] <= b[j]:
            r.append(a[i]); i += 1
        else:
            r.append(b[j]); j += 1
    return r
print(mesclar([1, 4, 7], [2, 3, 9, 10]))
def mesclar_certa(a, b):
    r = []
    i = j = 0
    while i < len(a) and j < len(b):
        if a[i] <= b[j]:
            r.append(a[i]); i += 1
        else:
            r.append(b[j]); j += 1
    return r + a[i:] + b[j:]
print(mesclar_certa([5, 1], [4, 2]))
print("fim")A saída é [1, 2, 3], depois [1, 2, 3, 4, 7], depois [4, 2, 5, 1] e por fim fim.
No primeiro caso, o quick_sort_ruim separa só menores e maiores, sem guardar os iguais. A lista [3, 1, 3, 2, 3] tem cinco elementos, e o resultado, três: os dois 3 repetidos sumiram, porque nem x < pivo nem x > pivo os captura. O resultado parece ordenado e tem o tamanho errado. É por isso que a versão correta tem a lista iguais.
No segundo, a mesclar esquece de copiar o que sobrou depois que uma das listas acaba. Os valores 9 e 10, que restavam em b, sumiram: o resultado tem cinco elementos, e as listas somavam sete. A versão certa termina com r + a[i:] + b[j:].
O terceiro mostra uma exigência que a função não verifica: a mesclar supõe que as duas listas já estão ordenadas. Com [5, 1] e [4, 2], que não estão, o resultado é [4, 2, 5, 1], sem erro e sem ordem. Mesclar não ordena: junta duas coisas que já estavam em ordem.
O que costuma aparecer em sala
São padrões que se repetem com quem aprende esses algoritmos. Não são relato de uma turma específica.
Esquecer o caso base. A função chama a si mesma até estourar. A pergunta que ajuda é: qual é a menor lista que eu sei ordenar sem fazer nada?
Esquecer de juntar o resultado. Escrever merge_sort(lista[:meio]) sem guardar nem usar o que ela devolve. A função roda, mas a lista ordenada se perde, porque o merge sort desta forma não altera a lista no lugar.
Perder o que sobrou na mesclagem. O resultado vem sem os maiores elementos, e quem olha só o começo da lista não percebe. Comparar o len do resultado com a soma dos tamanhos é um teste rápido.
Perder os repetidos no quick sort. Separar só menores e maiores, sem uma lista de iguais. O erro só aparece com valores repetidos, e as listas de teste costumam ter todos os valores diferentes.
Achar que o quick sort é sempre rápido. Quem só testa com listas embaralhadas nunca vê o pior caso. Uma lista já ordenada, com o pivô no primeiro elemento, é o teste que o revela.
Esperar que a recursão funcione para qualquer tamanho. No computador, o limite é de cerca de mil chamadas. Na placa, e no simulador, o limite de recursão é bem menor, e o mesmo código pode falhar.
Confundir mesclar com ordenar. A mesclagem só funciona com listas ordenadas. Chamar mesclar com listas desordenadas devolve uma lista desordenada.
Querer usar esses algoritmos no lugar do sorted(). Na prática, é o contrário: escreve-se à mão para entender, e usa-se a função pronta no programa.
Exercício: ordenar com merge sort e achar a mediana
Escreva um programa que leia a quantidade n de números, depois os n valores, ordene-os com merge sort e mostre a lista antes e depois e a mediana. O bloco usa entradas= para fornecer 6 números: 38, 27, 43, 3, 9 e 82.
def mesclar(a, b):
    resultado = []
    i = 0
    j = 0
    while i < len(a) and j < len(b):
        if a[i] <= b[j]:
            resultado.append(a[i])
            i += 1
        else:
            resultado.append(b[j])
            j += 1
    resultado.extend(a[i:])
    resultado.extend(b[j:])
    return resultado
def merge_sort(lista):
    if len(lista) <= 1:
        return lista
    meio = len(lista) // 2
    return mesclar(merge_sort(lista[:meio]), merge_sort(lista[meio:]))
n = int(input())
valores = []
for i in range(n):
    valores.append(int(input()))
ordenados = merge_sort(valores)
print("antes", valores)
print("depois", ordenados)
print("mediana", ordenados[n // 2])
print("fim")O simulador repete na saída os valores digitados, um por linha, e depois vêm antes [38, 27, 43, 3, 9, 82], depois [3, 9, 27, 38, 43, 82], mediana 38 e fim.
O programa mantém a lista valores intacta, porque o merge sort devolve uma lista nova, e mostra as duas. A mediana, para uma quantidade par de números como estes seis, é a média dos dois do meio, 27 e 38. A linha ordenados[n // 2] pega só o elemento da posição 3, o 38, o que serve para quantidades ímpares e é uma aproximação para as pares. Para treinar, tente: calcular a mediana certa para quantidades pares, com a média dos dois valores centrais; trocar o merge sort por sorted() e comparar; ordenar do maior para o menor, trocando o <= por >= na mesclagem; e contar quantas comparações a mesclagem faz.
Perguntas frequentes
O merge sort é melhor que o quick sort? Depende. O merge sort tem custo regular e é estável, mas usa listas novas. O quick sort no lugar usa pouca memória, mas pode degenerar com um pivô ruim.
Por que o merge sort é estável? Porque, no empate, a mesclagem pega primeiro o elemento da lista da esquerda, com <=. Assim os iguais mantêm a ordem em que entraram.
Qual pivô devo escolher no quick sort? O elemento do meio é uma boa escolha simples, e funciona bem com listas já ordenadas. Mais robusto é o mediano de três. O primeiro ou o último elemento é a pior escolha para listas que costumam vir ordenadas.
O sorted() usa um desses algoritmos? O Python usa um algoritmo próprio, híbrido, que combina ideias de mesclagem e de inserção. O do MicroPython é outro, e não é estável, como o artigo sobre lambda, map, filter e sorted mostrou.
Para que a recursão, se há laços? Porque a ideia de dividir e resolver partes menores é naturalmente recursiva. É possível escrever os dois sem recursão, com uma pilha própria, mas o código fica bem mais longo.
Esses algoritmos servem para listas pequenas? Servem, mas não compensam. Para poucos elementos, o insertion sort ou o sorted() são mais simples e igualmente rápidos.
Para continuar
Os desafios Soma da Lista, Maior da Lista e Lista ao Contrário praticam o percurso e a montagem de listas novas que a mesclagem usa. Para rever a base, vale passar pelos artigos sobre recursividade, funções com def, bubble e selection sort e insertion sort, e pela trilha de lógica.
O próximo artigo fecha esta parte com a complexidade de algoritmos, a notação Big-O: como dar nome ao que se viu aqui, o trabalho que cresce com o quadrado de n nos algoritmos simples e com n * log2(n) no merge sort.