Fundamentos
lambda, map, filter e sorted com key em Python
Aprenda lambda, map, filter e sorted com key em Python: funções pequenas passadas como argumento, o que cada uma faz e a ordenação instável do MicroPython.
Por Prof. Rodrigo Faustino · Atualizado em · 14 min de leitura
A lambda é uma função pequena, sem nome, escrita numa linha só: lambda n: n * 2 recebe n e devolve o dobro. Ela serve principalmente para ser passada como argumento a outra função, e as três que mais a recebem são map, que transforma cada item de um grupo, filter, que mantém só os itens que passam num teste, e sorted, que ordena pelo valor que a função de key calcula para cada item.
O que torna isso possível é uma ideia que apareceu de relance no artigo sobre def: em Python, uma função é um valor, como um número ou um texto. Dá para guardá-la numa variável, passá-la como argumento e devolvê-la de outra função. Este artigo fecha o módulo de funções mostrando essa ideia em ação. Vamos escrever lambdas, usar map, filter e sorted, ver os erros que aparecem no caminho e conhecer um comportamento do sorted no MicroPython que difere do Python do computador e pode surpreender quem ordena dados de sensores.
Funções são valores
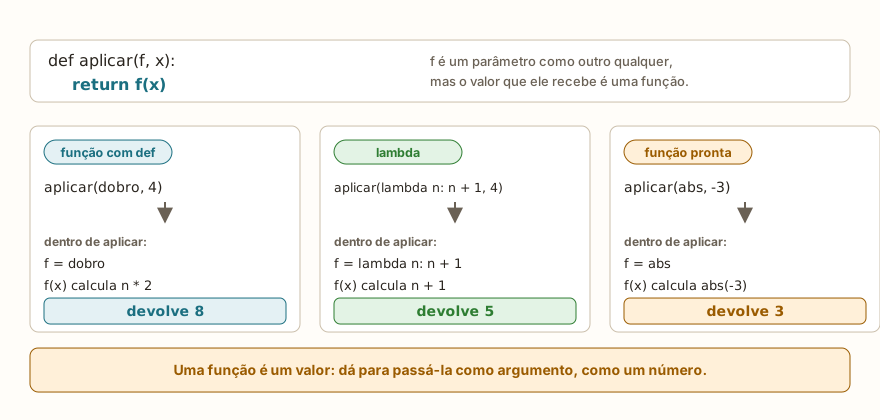
Até aqui, toda função foi chamada pelo nome, com parênteses. Mas o nome sem parênteses, como dobro, é só uma referência à função, e dá para entregá-la a outra função:
def aplicar(f, x):
    return f(x)

def dobro(n):
    return n * 2

print(aplicar(dobro, 4))
print(aplicar(lambda n: n + 1, 4))
print(aplicar(abs, -3))
print(aplicar(str, 42) + "!")
f = dobro
print(f(10))
print(type(f))A saída é 8, 5, 3, 42!, 20 e <class 'function'>. A função aplicar não sabe o que f faz, só que ela recebe um valor e devolve outro. Na primeira chamada, f é o dobro. Na segunda, é uma lambda escrita na hora. Na terceira, é a função pronta abs, e na quarta é str, que converte para texto. A linha f = dobro mostra que a função pode ser guardada numa variável e chamada por outro nome, e o type(f) confirma que o valor é uma função.
Esse padrão, uma função que recebe outra, aparece o tempo todo em Python e é a base de map, filter e sorted.
A IA que lembra da sua vida e mora no seu computador
- Memória de longo prazo com a fonte de cada resposta
- Funciona offline: seus dados ficam no seu PC
- Lê PDFs, slides, fotos e gravações de reunião
Plano Essencial grátis para sempre
lambda: uma função de uma expressão
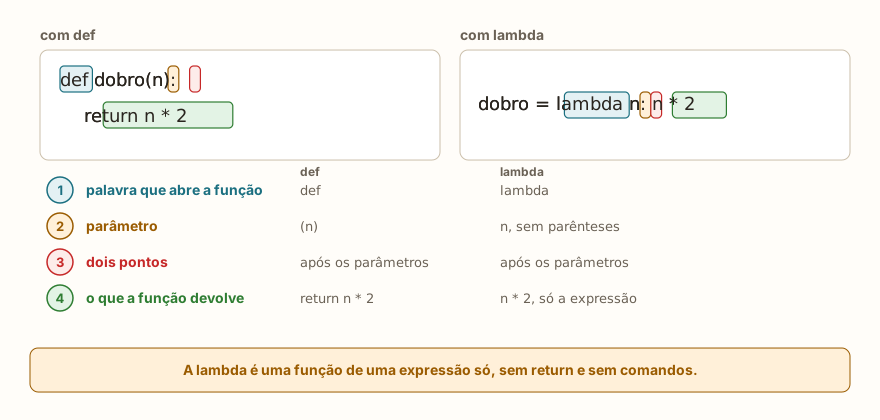
A lambda é a forma curta de escrever uma função simples. A figura mostra a mesma função dobro escrita das duas maneiras. Na lambda, a palavra substitui o def, os parâmetros ficam sem parênteses, os dois pontos vêm depois deles e o que vem a seguir é uma expressão, cujo valor é devolvido automaticamente, sem escrever return.
def dobro(n):
    return n * 2

dobro_l = lambda n: n * 2
print(dobro(4), dobro_l(4))
print((lambda a, b: a + b)(2, 3))
ola = lambda: "ola"
print(ola())
par = lambda n: "par" if n % 2 == 0 else "impar"
print(par(4), par(7))
pot = lambda base, exp=2: base ** exp
print(pot(5), pot(2, 10))A saída é 8 8, 5, ola, par impar e 25 1024. A lambda aceita zero, um ou mais parâmetros, e até valores padrão, como o exp=2 da potência. A linha (lambda a, b: a + b)(2, 3) cria a função e a chama no mesmo ponto, o que raramente se faz fora de exemplos. O par mostra a expressão condicional, valor1 if condição else valor2, que é a forma de colocar uma decisão dentro de uma única expressão.
A restrição que define a lambda é que o corpo é uma só expressão. Não cabem return, atribuições, if em várias linhas nem laços:
f = lambda n: return nTraceback (most recent call last):
File "main.py", line 1
SyntaxError: invalid syntaxO mesmo vale para uma atribuição dentro da lambda, que dá SyntaxError: can't assign to expression. O print dentro de uma lambda é permitido, porque é uma chamada, e portanto uma expressão.
A lambda não tem nome: no print(dobro) aparece <function <lambda> at 0x3ffb0010>, o endereço varia. Isso torna as mensagens de erro menos claras. Por isso a regra de bom uso é a seguinte: se a função vai ser reutilizada ou tem mais de uma linha de lógica, use def e dê um nome. A lambda é para o trecho curto que será entregue a outra função e usado ali mesmo.
map: transformar cada item
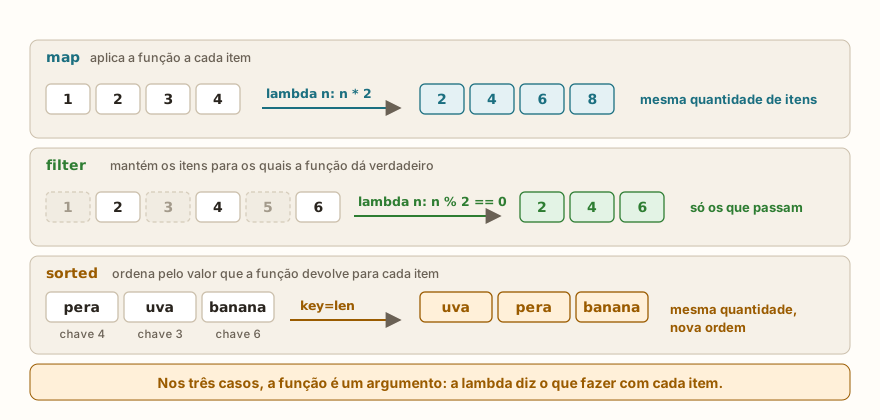
O map(função, grupo) aplica a função a cada item do grupo e produz os resultados. Ele devolve um objeto que gera os valores sob demanda, e para ver os resultados como lista é preciso convertê-lo com list():
numeros = [1, 2, 3, 4]
dobros = map(lambda n: n * 2, numeros)
print(list(dobros))
print(list(map(str, numeros)))
print(list(map(lambda a, b: a + b, [1, 2, 3], [10, 20, 30])))
for d in map(lambda n: n * n, range(1, 5)):
    print(d, end=" ")
print()
print(sum(map(lambda n: n * 2, numeros)))A saída é [2, 4, 6, 8], ['1', '2', '3', '4'], [11, 22, 33], 1 4 9 16 e 20. Com dois grupos, a função recebe um item de cada por vez, como na soma par a par. Num for ou num sum, o map pode ser usado sem converter. A quantidade de itens da saída é igual à da entrada, como mostra a figura.
Duas armadilhas do map valem registro. A primeira é que o resultado não é uma lista:
m = map(lambda n: n * 2, [1, 2, 3])
print(m[0])Traceback (most recent call last):
File "main.py", line 2, in <module>
TypeError: 'map' object isn't subscriptableO Python do computador escreve is not subscriptable. O mesmo ocorre com len(m), que dá object of type 'map' has no len(). A segunda é que o map se esgota depois de usado uma vez:
m = map(lambda n: n + 1, [1, 2])
print(list(m))
print(list(m))A saída é [2, 3] e depois []. A segunda conversão já não encontra valores, porque a primeira consumiu tudo. Quando o resultado será usado mais de uma vez, guarde a lista: dobros = list(map(...)).
filter: manter só o que passa
O filter(função, grupo) mantém os itens para os quais a função devolve verdadeiro. A função é um teste, como as condições dos artigos sobre if:
numeros = [1, 2, 3, 4, 5, 6]
pares = filter(lambda n: n % 2 == 0, numeros)
print(list(pares))
print(list(filter(lambda n: n > 3, numeros)))
print(list(filter(None, [0, 1, "", "a", None, 2, [], [3]])))
print(list(filter(lambda s: len(s) > 3, ["pera", "uva", "banana", "kiwi"])))A saída é [2, 4, 6], [4, 5, 6], [1, 'a', 2, [3]] e ['pera', 'banana', 'kiwi']. A figura mostra o primeiro caso, com os ímpares apagados. A terceira linha usa None no lugar da função: o filter então mantém os itens verdadeiros e descarta os "vazios", como o 0, o texto vazio, o None e a lista vazia. É um atalho prático para limpar um grupo.
O filter tem o mesmo comportamento de objeto sob demanda do map, e as mesmas armadilhas: precisa de list() para virar lista e se esgota depois de usado. Os erros de tipo aparecem quando o segundo argumento não é um grupo:
print(list(filter(lambda n: n > 1, 5)))Traceback (most recent call last):
File "main.py", line 1, in <module>
TypeError: 'int' object isn't iterableO Python do computador diz 'int' object is not iterable.
Da ementa ao semestre planejado
- Plano de ensino e calendário montados sozinhos
- Diário de aulas pronto para colar no SIGA
- Slides e listas de exercícios com gabarito
Versão Community grátis · Windows
sorted: ordenar com key
O sorted(grupo) devolve uma lista nova com os itens em ordem crescente, sem alterar o original. Com reverse=True, a ordem é decrescente. E com key=função, a ordenação deixa de comparar os itens diretamente e compara o valor que a função calcula para cada um:
nums = [3, 1, 2]
print(sorted(nums))
print(sorted(nums, reverse=True))
print(nums)
palavras = ["pera", "uva", "banana"]
print(sorted(palavras))
print(sorted(palavras, key=len))
print(sorted(palavras, key=len, reverse=True))A saída é [1, 2, 3], [3, 2, 1], [3, 1, 2], ['banana', 'pera', 'uva'], ['uva', 'pera', 'banana'] e ['banana', 'pera', 'uva']. O nums continua [3, 1, 2], porque o sorted não mexe nele. Sem key, os textos são ordenados em ordem alfabética. Com key=len, ordenam-se pelo tamanho: uva (3), pera (4), banana (6), e com reverse=True a ordem se inverte. A figura mostra o caso do key=len. Aqui todas as chaves são diferentes, e isso importa para o próximo ponto.
O método lista.sort() ordena a própria lista, no lugar, e devolve None:
lista = [3, 1, 2]
r = lista.sort()
print(r, lista)
nova = sorted([3, 1, 2])
print(nova)A saída é None [1, 2, 3] e [1, 2, 3]. Escrever lista = lista.sort() é um erro clássico: a variável passa a guardar None e a lista se perde.
O key é muito útil com tuplas, quando cada item tem várias partes:
sensores = [("sala", 24.5), ("cozinha", 27.0), ("quarto", 22.5)]
mais_quente = max(sensores, key=lambda s: s[1])
print("mais quente:", mais_quente[0], mais_quente[1])
for nome, temp in sorted(sensores, key=lambda s: s[1]):
    print(nome, temp)
frias = list(filter(lambda s: s[1] < 25, sensores))
print(frias)
nomes = list(map(lambda s: s[0], sensores))
print(nomes)A saída é mais quente: cozinha 27.0, as três linhas quarto 22.5, sala 24.5 e cozinha 27.0, [('sala', 24.5), ('quarto', 22.5)] e ['sala', 'cozinha', 'quarto']. O s[1] pega a temperatura de cada tupla. As funções max e min também aceitam key, e o max devolve a tupla inteira, o que permite saber qual sensor tem o maior valor, e não só o valor. O map com s[0] extrai só os nomes.
Atenção: o sorted do MicroPython não é estável
Uma ordenação é estável quando itens com a mesma chave ficam na mesma ordem em que estavam. O Python do computador garante isso. O MicroPython não: o código dele usa um algoritmo de ordenação que pode trocar a ordem de itens empatados, e o simulador do projeto reproduz o algoritmo da placa. O mesmo programa dá resultados diferentes:
palavras = ["pera", "uva", "banana", "kiwi"]
print(sorted(palavras, key=len))
print(sorted(palavras, key=lambda s: (len(s), s)))No simulador, a saída é ['uva', 'kiwi', 'pera', 'banana'] nas duas linhas. No Python do computador, a primeira linha dá ['uva', 'pera', 'kiwi', 'banana'], com pera antes de kiwi, como na lista original. As palavras pera e kiwi têm o mesmo tamanho, 4, e empatam. O computador mantém a ordem de entrada. O simulador inverte.
Na prática, quando há empate, a ordem entre os empatados não é garantida na ESP32. A solução é eliminar o empate com uma chave composta, uma tupla com o critério principal e um de desempate:
leituras = [("a", 30), ("b", 12), ("c", 25), ("d", 12), ("e", 12)]
print(sorted(leituras, key=lambda t: (t[1], t[0])))
print(sorted(["b", "A", "c", "B"], key=lambda s: (s.lower(), s)))A saída é [('b', 12), ('d', 12), ('e', 12), ('c', 25), ('a', 30)] e ['A', 'B', 'b', 'c'], iguais no simulador e no computador. A chave (t[1], t[0]) ordena primeiro pelo valor e, nos empates, pelo nome, e o resultado fica previsível. Sempre que a ordem dos empatados importar, como numa lista de classificação ou num relatório de sensores, desempate com uma chave composta.
Outro detalhe do simulador, que também reproduz a placa: a função key é chamada a cada comparação, e não uma vez por item. Contando as chamadas numa lista de 8 itens, o simulador faz 19, e o Python do computador faz 8:
chamadas = 0
def chave(x):
    global chamadas
    chamadas += 1
    return x

lista = [5, 3, 8, 1, 9, 2, 7, 4]
r = sorted(lista, key=chave)
print(r, "chamadas da key:", chamadas, "itens:", len(lista))A saída é [1, 2, 3, 4, 5, 7, 8, 9] chamadas da key: 19 itens: 8. Isso importa em dois casos: uma key lenta, que consulta um sensor, por exemplo, será chamada muitas vezes, e uma key com efeito colateral, como um print, aparecerá mais vezes do que o esperado. Mantenha a key curta e sem efeito colateral.
Erros comuns com sorted
Ordenar valores de tipos incomparáveis dá TypeError:
print(sorted([3, "a", 1]))Traceback (most recent call last):
File "main.py", line 1, in <module>
TypeError: unsupported types for __lt__: 'int', 'str'O Python do computador escreve '<' not supported between instances of 'str' and 'int'. A causa é uma lista que mistura números e textos, como acontece quando uma leitura chega como texto. Converta antes, com int() ou float(), ou use uma key que normalize. Passar algo que não é um grupo, como sorted(5), dá 'int' object isn't iterable. E uma key com a quantidade errada de parâmetros também falha:
print(sorted(["a", "b"], key=lambda: 1))Traceback (most recent call last):
File "main.py", line 1, in <module>
TypeError: function takes 0 positional arguments but 1 were givenA key sempre recebe um argumento, o item, então a lambda precisa de um parâmetro, como lambda s: ....
Uma armadilha da lambda dentro de laços
Quando uma lambda usa uma variável de fora, ela guarda o nome, e não o valor do momento em que foi criada. O valor só é lido quando a lambda é chamada:
fs = []
for i in range(3):
    fs.append(lambda: i)
print(fs[0](), fs[1](), fs[2]())
gs = []
for i in range(3):
    gs.append(lambda i=i: i)
print(gs[0](), gs[1](), gs[2]())A saída é 2 2 2 e 0 1 2. Na primeira versão, as três lambdas olham o mesmo i, que no fim do laço vale 2. Na segunda, o i=i é um parâmetro com valor padrão, e o padrão é calculado na criação, de modo que cada lambda guarda o seu. É o mesmo mecanismo do artigo sobre escopo, e aparece principalmente ao criar vários tratadores de evento num laço.
Na ESP32
Os três recursos se encaixam bem no tratamento de leituras. Retomando o exemplo do ADC, que lê de 0 a 4095, o filter descarta as leituras fora da faixa, o max e o min acham os extremos e o sorted as ordena:
leituras = [512, -1, 530, 4096, 498]
validas = list(filter(lambda v: 0 <= v <= 4095, leituras))
print(validas)
print("maior", max(validas), "menor", min(validas))
print(sorted(validas, reverse=True))
print("media", sum(validas) / len(validas))
percentual = list(map(lambda v: v * 100 // 4095, validas))
print(percentual)A saída é [512, 530, 498], maior 530 menor 498, [530, 512, 498], media 513.3333 e [12, 12, 12]. O mesmo conjunto de leituras apareceu no artigo sobre break e continue, com um laço e um continue; aqui o filter faz o trabalho do descarte em uma linha. O 513.3333 é o float de 32 bits do simulador, e o Python do computador mostraria 513.3333333333334. O artigo sobre ADC explica a faixa de leitura.
As lambdas também são o jeito usual de escrever tratadores de evento curtos. O simulador aceita registrar uma na interrupção de um botão:
from machine import Pin

botao = Pin(4, Pin.IN, Pin.PULL_UP)
botao.irq(handler=lambda p: print("apertou", p), trigger=Pin.IRQ_FALLING)
print("irq configurado")O Serial mostra irq configurado. O tratador só é chamado quando o evento acontece, e recebe o pino como argumento, o p da lambda. O handler= e o trigger= são argumentos nomeados, como no artigo sobre parâmetros. Se o tratador precisar de mais de uma linha ou alterar uma variável global, escreva uma função com def. O artigo sobre programar sem travar trata de como organizar esse tipo de código.
Em sala de aula: onde estes recursos costumam tropeçar
Estes casos se repetem nas turmas.
Esquecer o list() depois do map ou do filter
O aluno imprime map(...) e vê <map object at 0x3ffb0020>, achando que o computador "não calculou". O objeto só gera os valores quando alguém os pede, e o list() pede todos.
Usar o resultado duas vezes
O primeiro uso funciona e o segundo vem vazio, porque map e filter se esgotam. A solução é guardar a lista.
Lambda com mais de uma linha
O aluno tenta colocar um if com else em linhas separadas, ou um return, dentro da lambda, e recebe SyntaxError. Quando a lógica precisa de mais de uma expressão, é hora de usar def.
Atribuir a lista ordenada ao resultado do sort
lista = lista.sort() deixa None na variável. A escolha é entre lista.sort(), que ordena no lugar, e lista = sorted(lista), que cria uma nova.
Esperar estabilidade no sorted da ESP32
O programa funciona perfeitamente no computador, e na placa os empatados aparecem em outra ordem. O desempate com chave composta resolve, e vale incluí-lo sempre que a ordem dos iguais fizer diferença.
Comparar tipos misturados
Uma lista com 3, "a" e 1. Acontece muito com dados lidos de arquivo ou de uma entrada, em que tudo chega como texto. A conversão com int() antes de ordenar evita o TypeError.
As lambdas do laço que dão todas o mesmo valor
O caso do 2 2 2. A correção é o i=i, e o sintoma é sempre o mesmo: todas as funções criadas no laço respondem com o valor do último passo.
Exercício: ranking de alunos
Dada uma lista de alunos com nota, produza três coisas: o ranking da maior para a menor nota, a lista dos aprovados (nota 7 ou mais) e a lista dos nomes em maiúsculas.
alunos = [("Ana", 8.5), ("Bia", 6.0), ("Caio", 9.0), ("Duda", 6.0)]
print(sorted(alunos, key=lambda a: a[1], reverse=True))
aprovados = list(filter(lambda a: a[1] >= 7, alunos))
print(aprovados)
print(list(map(lambda a: a[0].upper(), alunos)))A saída é [('Caio', 9.0), ('Ana', 8.5), ('Bia', 6.0), ('Duda', 6.0)], [('Ana', 8.5), ('Caio', 9.0)] e ['ANA', 'BIA', 'CAIO', 'DUDA']. Repare que Bia e Duda empatam com 6.0. Neste exemplo a ordem deles coincidiu com a do computador, mas, como a ordenação do MicroPython não é estável, não há garantia de que isso se repita com outros dados. Para melhorar, troque a chave por lambda a: (-a[1], a[0]), que ordena por nota decrescente e, nos empates, por nome, e confirme que o resultado fica previsível. O sinal de menos inverte a nota sem precisar de reverse=True.
Perguntas frequentes
O que é uma função anônima?
É uma função sem nome. A lambda cria uma, e por isso o Python a mostra como <lambda> nas mensagens.
Posso guardar uma lambda numa variável?
Pode, como em dobro = lambda n: n * 2. Funciona, mas se a função merece um nome, o def é mais claro e dá mensagens de erro melhores.
Quando usar map e filter, e quando usar um laço?
Quando a transformação ou o teste cabe numa expressão curta, as duas formas funcionam, e a escolha é de leitura. Se o corpo precisa de várias linhas, o laço é melhor. O próximo módulo da série mostra as compreensões de lista, que fazem o mesmo trabalho de map e filter de um jeito que muita gente acha mais legível.
Por que sorted e sort existem os dois?
O sorted aceita qualquer grupo e devolve uma lista nova. O sort é um método de lista, ordena a própria lista e devolve None. Use o sorted quando precisar do original.
O que muda no MicroPython?
A principal diferença é a ordenação não estável: itens empatados podem sair em outra ordem, e a key é chamada várias vezes por item. O resto, lambda, map e filter, se comporta como no computador.
Dá para usar key em min e max?
Dá. O max(sensores, key=lambda s: s[1]) devolve o item com o maior valor de s[1], e não só o valor.
Para continuar
Este artigo fecha o módulo de funções. Se quiser rever a base, volte aos artigos sobre funções, parâmetros e argumentos, return, escopo e recursividade. Os desafios Função Dobro e Maior de Dois podem ser resolvidos também com lambda, como exercício opcional, e a trilha Lógica com Python reúne todos os desafios.
O próximo artigo abre o módulo de estruturas de dados com as listas: como criar, acessar, alterar e percorrer, que é o que vários exemplos deste artigo já usaram sem apresentar.