Fundamentos
Insertion sort em Python e quando usar sorted()
Aprenda o insertion sort, compare-o com bubble e selection, veja por que ele é estável e saiba quando usar sorted() e sort() em vez de escrever à mão.
Por Prof. Rodrigo Faustino · Atualizado em · 16 min de leitura
Quem joga cartas conhece o insertion sort sem saber. Ao receber cada carta, a pessoa a encaixa no lugar certo entre as que já tem na mão, deslocando as maiores para abrir espaço. A mão está sempre ordenada, e cada carta nova só precisa achar a sua posição. É exatamente isso que o algoritmo faz com uma lista: a parte da esquerda fica ordenada, e o próximo elemento é inserido nela.
Este artigo é o terceiro dos algoritmos simples de ordenação, depois do bubble sort e do selection sort. Ele mostra como o insertion sort funciona, por que anda tão bem em listas quase ordenadas, por que é estável, e fecha a pergunta que sobrou desde o início: se o Python já tem sorted() e sort(), quando vale escrever a ordenação à mão? Todos os exemplos rodaram no simulador, e os resultados citados são os que ele produz.
Insertion sort: encaixar um por vez

O algoritmo começa considerando que o primeiro elemento, sozinho, já é uma lista ordenada. Depois pega o segundo e o encaixa no lugar certo, depois o terceiro, e assim até o último. Para encaixar, guarda-se o elemento numa variável, a chave, e anda-se para trás pela parte ordenada, empurrando uma casa para a direita cada valor maior que a chave, até achar o lugar dela.
def insertion(lista):
    for i in range(1, len(lista)):
        chave = lista[i]
        j = i - 1
        while j >= 0 and lista[j] > chave:
            lista[j + 1] = lista[j]
            j -= 1
        lista[j + 1] = chave
    return lista

print(insertion([5, 2, 4, 6, 1, 3]))
print(insertion([3, 3, 1]), insertion([]), insertion([7]), insertion([1, 2, 3]))

def insertion_passos(lista):
    for i in range(1, len(lista)):
        chave = lista[i]
        j = i - 1
        deslocou = 0
        while j >= 0 and lista[j] > chave:
            lista[j + 1] = lista[j]
            j -= 1
            deslocou += 1
        lista[j + 1] = chave
        print("i", i, "chave", chave, "deslocou", deslocou, lista)
    return lista
insertion_passos([5, 2, 4, 6, 1, 3])

def insertion_conta(lista):
    comparacoes = 0
    deslocamentos = 0
    for i in range(1, len(lista)):
        chave = lista[i]
        j = i - 1
        while j >= 0:
            comparacoes += 1
            if lista[j] > chave:
                lista[j + 1] = lista[j]
                deslocamentos += 1
                j -= 1
            else:
                break
        lista[j + 1] = chave
    return comparacoes, deslocamentos
print(insertion_conta([5, 2, 4, 6, 1, 3]))
print(insertion_conta([1, 2, 3, 4, 5]))
print(insertion_conta([5, 4, 3, 2, 1]))
print("fim")A saída começa com [1, 2, 3, 4, 5, 6] e [1, 3, 3] [] [7] [1, 2, 3]. O passo a passo é i 1 chave 2 deslocou 1 [2, 5, 4, 6, 1, 3], i 2 chave 4 deslocou 1 [2, 4, 5, 6, 1, 3], i 3 chave 6 deslocou 0 [2, 4, 5, 6, 1, 3], i 4 chave 1 deslocou 4 [1, 2, 4, 5, 6, 3] e i 5 chave 3 deslocou 3 [1, 2, 3, 4, 5, 6]. As contagens são (12, 9), (4, 0) e (10, 10), e por fim fim.
Vale ler a função insertion linha por linha:
for i in range(1, len(lista))percorre os elementos a partir do segundo. O de índice 0 não precisa ser tratado, já que sozinho está ordenado.chave = lista[i]guarda o valor que será encaixado. Esse passo é essencial, e a próxima seção mostra o que acontece sem ele.j = i - 1aponta para o último elemento da parte ordenada, o vizinho imediato da chave.while j >= 0 and lista[j] > chaveanda para trás enquanto ainda houver elementos e enquanto o elemento olhado for maior que a chave. A ordem das duas condições importa: oj >= 0vem primeiro porque, sejfosse-1, olista[j]olharia o último elemento da lista, e não um elemento inexistente.lista[j + 1] = lista[j]desloca o maior uma casa para a direita, ej -= 1passa ao próximo.lista[j + 1] = chavegrava a chave no buraco que sobrou. Quando o laço para,japonta para o primeiro elemento que não é maior que a chave, ou para-1se não houver nenhum, e o lugar da chave é logo depois.
Deslocar em vez de trocar

Há uma diferença sutil em relação ao bubble sort. O bubble troca dois vizinhos a cada passo, o que mexe em duas posições. O insertion desloca: copia um valor para a posição ao lado, e só no fim grava a chave. A figura mostra o passo i = 4 da lista de exemplo, onde a chave é o 1. O 1 é guardado, o que deixa um buraco na posição 4. O 6 anda para o buraco, o 5 para o buraco que o 6 deixou, e assim por diante, até o buraco chegar à posição 0. Então a chave cai nele. Cada valor é copiado uma vez, e a chave é escrita uma vez, o que dá menos trabalho de escrita que uma sequência de trocas.
Os resultados da função insertion_passos mostram como o trabalho varia. O 6, no passo i = 3, já estava no lugar certo e deslocou zero valores. O 1, no passo seguinte, era menor que todos os da parte ordenada e foi até o começo, deslocando quatro. O total, 9 deslocamentos e 12 comparações, é bem menor que o máximo possível.
Da ementa ao semestre planejado
- Plano de ensino e calendário montados sozinhos
- Diário de aulas pronto para colar no SIGA
- Slides e listas de exercícios com gabarito
Versão Community grátis · Windows
Os três lado a lado
def bubble(lista):
    c = t = 0
    n = len(lista)
    for i in range(n - 1):
        trocou = False
        for j in range(n - 1 - i):
            c += 1
            if lista[j] > lista[j + 1]:
                lista[j], lista[j + 1] = lista[j + 1], lista[j]
                t += 1
                trocou = True
        if not trocou:
            break
    return c, t
def selection(lista):
    c = t = 0
    n = len(lista)
    for i in range(n - 1):
        m = i
        for j in range(i + 1, n):
            c += 1
            if lista[j] < lista[m]:
                m = j
        if m != i:
            lista[i], lista[m] = lista[m], lista[i]
            t += 1
    return c, t
def insertion(lista):
    c = d = 0
    for i in range(1, len(lista)):
        chave = lista[i]
        j = i - 1
        while j >= 0:
            c += 1
            if lista[j] > chave:
                lista[j + 1] = lista[j]
                d += 1
                j -= 1
            else:
                break
        lista[j + 1] = chave
    return c, d
n = 100
ordenada = list(range(1, n + 1))
quase = list(range(1, n + 1))
quase[10], quase[11] = quase[11], quase[10]
quase[50], quase[51] = quase[51], quase[50]
quase[90], quase[91] = quase[91], quase[90]
invertida = list(range(n, 0, -1))
for nome, base in [("ordenada", ordenada), ("quase", quase), ("invertida", invertida)]:
    print(nome, "bubble", bubble(base[:]), "selection", selection(base[:]), "insertion", insertion(base[:]))
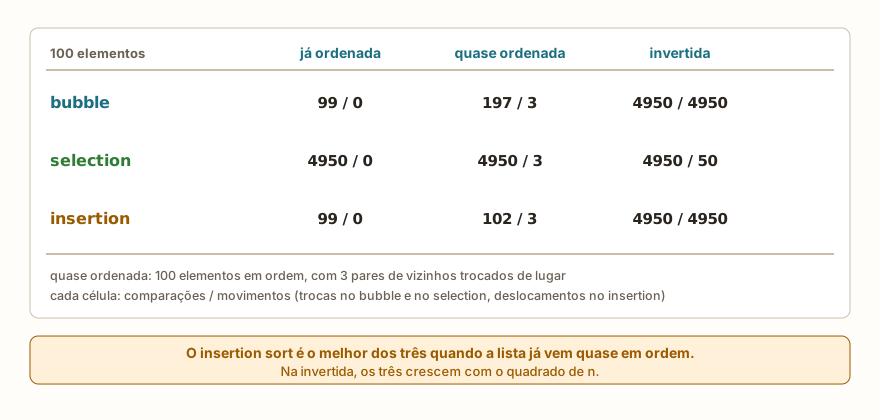
print("fim")A saída tem três linhas: ordenada bubble (99, 0) selection (4950, 0) insertion (99, 0), depois quase bubble (197, 3) selection (4950, 3) insertion (102, 3), depois invertida bubble (4950, 4950) selection (4950, 50) insertion (4950, 4950), e por fim fim. Em cada par, o primeiro número é o de comparações e o segundo, o de movimentos: trocas no bubble e no selection, deslocamentos no insertion.
O caso do meio, quase ordenada, é o mais revelador. A lista tem 100 elementos em ordem, com três pares de vizinhos trocados de lugar. O insertion faz 102 comparações, uma por elemento mais três de acerto. O bubble com parada antecipada precisa de mais passadas e faz 197. O selection, que sempre varre tudo, faz 4950. Os três fazem só 3 movimentos, porque só há três pares fora de lugar.
Listas quase ordenadas aparecem mais do que parece. Um registro de leituras ao qual chega um valor novo por vez, uma lista que foi ordenada ontem e recebeu alguns itens hoje, um ranking que muda pouco a cada rodada. Nesses casos, o insertion sort faz um trabalho proporcional ao tamanho da desordem, e não ao tamanho da lista.
No pior caso, a lista invertida, os três crescem com o quadrado de n: 4950 comparações para 100 elementos. O selection ainda leva a vantagem de trocar pouco, 50 vezes, e os outros dois movimentam 4950 vezes. Nenhum dos três é escolha para listas grandes e desordenadas, e é isso que o próximo artigo ataca.
Estabilidade: o insertion sort mantém a ordem dos empates
Uma ordenação é estável quando elementos de mesma chave saem na mesma ordem em que entraram. Isso importa quando se ordena por um campo e se quer que o resto da ordem seja preservado, como ordenar alunos por nota e manter a ordem alfabética entre os que empatam. O artigo sobre lambda, map, filter e sorted mostrou que o sorted() do MicroPython não é estável. O insertion sort escrito à mão, com a comparação > estrita, é:
def insertion_por(lista, chave_fn):
    for i in range(1, len(lista)):
        item = lista[i]
        k = chave_fn(item)
        j = i - 1
        while j >= 0 and chave_fn(lista[j]) > k:
            lista[j + 1] = lista[j]
            j -= 1
        lista[j + 1] = item
    return lista
palavras = ["pera", "uva", "banana", "kiwi"]
print(insertion_por(palavras[:], len))
print(sorted(palavras, key=len))
leituras = [("a", 12), ("b", 30), ("c", 12), ("d", 25), ("e", 12), ("f", 30)]
print(insertion_por(leituras[:], lambda t: t[1]))
print(sorted(leituras, key=lambda t: t[1]))
print(sorted(leituras, key=lambda t: (t[1], t[0])))
print("fim")No simulador, a saída é ['uva', 'pera', 'kiwi', 'banana'], depois ['uva', 'kiwi', 'pera', 'banana'], depois [('a', 12), ('c', 12), ('e', 12), ('d', 25), ('b', 30), ('f', 30)], depois [('e', 12), ('c', 12), ('a', 12), ('d', 25), ('f', 30), ('b', 30)], depois [('a', 12), ('c', 12), ('e', 12), ('d', 25), ('b', 30), ('f', 30)] e fim.
Compare as linhas duas a duas. O insertion_por mantém pera antes de kiwi, e a, c e e na ordem original, que é a ordem estável. O sorted() do simulador, que imita o do MicroPython, inverte, nestes exemplos, os empates: kiwi antes de pera, e e, c, a. No Python de computador, o sorted() dá o mesmo resultado do insertion, e é por isso que o mesmo programa dá saídas diferentes no computador e na placa. A última linha mostra a saída para esse problema: com uma chave composta (t[1], t[0]), que desempata pelo nome, o sorted() dá a mesma resposta nos dois lugares.
Na função insertion_por, o detalhe que garante a estabilidade é o > estrito: o laço só desloca elementos maiores que a chave. Elementos iguais não são deslocados, e por isso a chave que acabou de chegar fica depois de todos os iguais que já estavam. A função também recebe a função de chave como argumento, chave_fn, e calcula chave_fn(item) uma vez por elemento, a mesma ideia do key do sorted().
Inserir em uma lista que já está ordenada
O passo central do insertion sort, encaixar um valor numa lista ordenada, serve sozinho. Quando os dados chegam um por vez, como leituras de um sensor, dá para manter uma lista sempre ordenada inserindo cada valor na posição certa, sem ordenar tudo de novo:
def inserir_ordenado(lista, valor):
    pos = 0
    while pos < len(lista) and lista[pos] < valor:
        pos += 1
    lista.insert(pos, valor)

top = []
for v in [40, 15, 70, 25, 55, 10, 80]:
    inserir_ordenado(top, v)
    if len(top) > 3:
        top.pop(0)
    print(v, top)
print(top)
ordem = []
for v in [5, 1, 4, 2, 8]:
    inserir_ordenado(ordem, v)
print(ordem)
print("fim")A saída é 40 [40], 15 [15, 40], 70 [15, 40, 70], 25 [25, 40, 70], 55 [40, 55, 70], 10 [40, 55, 70], 80 [55, 70, 80], depois [55, 70, 80], depois [1, 2, 4, 5, 8] e fim.
A função inserir_ordenado procura a posição, com um laço que anda enquanto os elementos forem menores que o valor, e usa o método insert(pos, valor), que coloca o valor na posição indicada e empurra os seguintes para a direita. O primeiro uso é um placar dos 3 maiores valores: a cada leitura nova, ela entra na lista ordenada, e, se a lista passar de 3, o pop(0) descarta o menor, que está no começo. A lista nunca guarda mais do que 3 valores, e termina com os três maiores da sequência, [55, 70, 80]. Repare que a leitura 10, pequena demais, entrou e foi imediatamente descartada.
O segundo uso mostra que repetir inserir_ordenado para cada elemento é o insertion sort: a lista ordem terminou ordenada, sem nenhuma função de ordenação.
Na placa, isso interessa por duas razões. A lista fica sempre pronta para consulta, o que permite, por exemplo, pegar a mediana a qualquer momento no elemento do meio, como o artigo anterior fez com um filtro de mediana. E a memória fica limitada, porque se guarda só o que interessa. As leituras de um sensor, como as dos artigos sobre sensores DHT22, HC-SR04 e PIR, são o uso natural.
A IA que lembra da sua vida e mora no seu computador
- Memória de longo prazo com a fonte de cada resposta
- Funciona offline: seus dados ficam no seu PC
- Lê PDFs, slides, fotos e gravações de reunião
Plano Essencial grátis para sempre
Quando usar sorted() e sort()
Na prática, quase sempre se usa as funções prontas. Elas já estão testadas, aceitam key e reverse, e dispensam o código. O quadro de decisão é curto:
print(sorted("python"))
print(sorted((3, 1, 2)))
print(sorted({"b": 1, "a": 2}))
print(sorted({3, 1, 2}))
print(sorted([3, 1, 2], reverse=True))
d = {"ana": 8.5, "bia": 6.0, "caio": 9.0}
print(sorted(d.items(), key=lambda kv: kv[1]))
print(sorted(d, key=d.get, reverse=True))
nums = [4, 2, 9, 1]
print(min(nums), max(nums), nums)
print(sorted(nums) == nums, nums == sorted(nums))
copia = nums[:]
copia.sort()
print(copia, nums)
copia.sort(reverse=True)
print(copia)
print("fim")A saída é ['h', 'n', 'o', 'p', 't', 'y'], [1, 2, 3], ['a', 'b'], [1, 2, 3], [3, 2, 1], [('bia', 6.0), ('ana', 8.5), ('caio', 9.0)], ['caio', 'ana', 'bia'], 1 9 [4, 2, 9, 1], False False, [1, 2, 4, 9] [4, 2, 9, 1], [9, 4, 2, 1] e fim.
O que cada trecho ensina:
- O
sorted()aceita qualquer coisa que se percorre, como texto, tupla, dicionário e conjunto, e sempre devolve uma lista. Para um dicionário, ordena as chaves. - O
sorted(..., reverse=True)ordena do maior ao menor. - Com
key, ordena-se por um critério. Od.items()entrega pares(nome, nota), e okv[1]escolhe a nota. Okey=d.getusa o próprio método do dicionário como função de chave, e dá os nomes do melhor ao pior. - O
sorted()não altera a lista original: as linhas comnumsmostram que ela continua[4, 2, 9, 1]. Já osort()ordena no lugar e devolveNone, como mostra o uso nacopia. - Para achar só o menor ou o maior, o
mine omaxbastam, e são mais simples do que ordenar tudo.
A regra de escolha, então, fica assim:
- Só quer a lista ordenada? Use
sorted(lista), oulista.sort()se não precisar da original. - Ordenar por um campo? Use
key, e, se os empates importam, uma chave composta, como visto acima. - Só o menor ou o maior? Use
minoumax, comkeyse preciso. - Os dados chegam um por vez e a lista precisa estar sempre ordenada? Insira cada valor com a ideia do
inserir_ordenado. - Quer entender, ou a regra de ordem é incomum? Escreva à mão, como exercício, ou quando nenhum
keyexpressa o critério.
Escrever o algoritmo à mão não é a escolha para código de produção. Mas, depois de ter escrito, é muito mais fácil entender o que o sorted() faz, por que ele pode ser lento numa key pesada e por que a estabilidade importa.
Erros comuns
O primeiro é ordenar valores de tipos diferentes:
print(sorted([3, "1", 2]))TypeError: unsupported types for __lt__: 'int', 'str'No Python de computador, a mensagem é '<' not supported between instances of 'str' and 'int'. Costuma aparecer quando os valores vêm de input() e ninguém os converteu com int().
O segundo é passar o reverse sem o nome:
print(sorted([3, 1, 2], True))TypeError: must use keyword argument for key functionNo Python de computador, a mensagem é sorted expected 1 argument, got 2. Nos dois casos, o reverse e o key só se passam por nome: sorted(lista, reverse=True).
O terceiro é usar uma função de chave que não serve para os itens:
nums = [3, 1, 2]
nums.sort(key=len)TypeError: object of type 'int' has no len()O len calcula o tamanho de textos e listas, e não de números. A mensagem é a mesma no simulador e no computador.
O quarto é o clássico de guardar o resultado do sort():
lista = [3, 1, 2]
lista = lista.sort()
print(len(lista))TypeError: object of type 'NoneType' has no len()O sort() devolve None, e a variável perdeu a lista. A mensagem também é igual nos dois ambientes. A correção é chamar lista.sort() sozinho, numa linha, ou usar lista = sorted(lista).
O quinto é pedir a ordenação de algo que não se percorre:
print(sorted(5))TypeError: 'int' object isn't iterableNo computador, a mensagem é 'int' object is not iterable.
O sexto é esquecer o j >= 0 no laço do insertion sort:
def insertion_erro(lista):
    for i in range(1, len(lista)):
        chave = lista[i]
        j = i - 1
        while lista[j] > chave:
            lista[j + 1] = lista[j]
            j -= 1
        lista[j + 1] = chave
    return lista
print(insertion_erro([5, 2, 4]))IndexError: list index out of rangeSem o teste, quando a chave é menor que todos os elementos da parte ordenada, j chega a -1 e continua descendo. Os índices negativos do Python contam do fim da lista, e por isso o laço olha elementos que não deveria, até j sair do alcance da lista inteira. É um erro que acontece justamente quando a chave é o menor valor, e por isso uma lista que só tem valores crescentes não o revela.
Armadilhas silenciosas
Sem a variável chave, a função não dá erro e ordena errado:
def insertion_sem_chave(lista):
    for i in range(1, len(lista)):
        j = i - 1
        while j >= 0 and lista[j] > lista[j + 1]:
            lista[j + 1] = lista[j]
            j -= 1
    return lista
print(insertion_sem_chave([5, 2, 4, 6, 1, 3]))
print("fim")A saída é [5, 5, 5, 6, 6, 6] e fim. A função sobrescreve lista[j + 1] com lista[j] sem ter guardado o valor original em lugar nenhum, e ele se perde. O resultado tem o tamanho certo e parece "meio ordenado", mas o 2, o 4, o 1 e o 3 desapareceram, e o 5 e o 6 se repetem. É o mesmo tipo de erro da troca feita com duas atribuições, no artigo anterior: para mover um valor sem perder o outro, é preciso guardá-lo antes. Aqui, quem guarda é a chave.
O que costuma aparecer em sala
São padrões que se repetem com quem aprende o insertion sort. Não são relato de uma turma específica.
Esquecer a chave. Gera [5, 5, 5, 6, 6, 6] e a pessoa não entende de onde vieram os repetidos. A pergunta que ajuda é: onde está guardado o valor que eu estou movendo?
A ordem das condições do while. Escrever lista[j] > chave and j >= 0. Quando j vale -1, a primeira condição já olha lista[-1], o último elemento, e o resultado deixa de ser confiável. A condição de limite vem sempre primeiro.
Gravar a chave no lugar errado. Escrever lista[j] = chave em vez de lista[j + 1] = chave. Depois do laço, j aponta para o elemento anterior ao lugar da chave, e a posição certa é a seguinte.
Confundir sort() com sorted(). Quem usa lista = lista.sort() perde a lista. Quem usa sorted(lista) sem guardar o resultado acha que a lista foi ordenada, e ela continua como estava.
Esperar a mesma ordem dos empates no computador e na placa. O programa passa nos testes no computador e se comporta diferente na ESP32. A chave composta, que elimina os empates, resolve.
Achar que escrever à mão é "mais certo". Algumas pessoas preferem o algoritmo próprio por desconfiar do sorted(). O contrário costuma ser verdade: a função pronta tem menos chance de ter um erro de limite.
Ordenar a cada leitura. Um programa que chama sorted() na lista toda a cada leitura nova de um sensor refaz o trabalho todo. Inserir o novo valor na posição certa, como no placar dos 3 maiores, faz muito menos.
Misturar tipos na lista. Um valor que veio como texto no meio de números derruba a ordenação com TypeError. Converter na leitura evita.
Exercício: ordenar palavras por tamanho
Escreva um programa que leia a quantidade n de palavras, depois as n palavras, e as ordene pelo tamanho com insertion sort, mostrando a lista e a mais curta e a mais longa. O bloco usa entradas= para fornecer 4 palavras: casa, sol, abacaxi e uva.
n = int(input())
palavras = []
for i in range(n):
    palavras.append(input())
for i in range(1, n):
    atual = palavras[i]
    j = i - 1
    while j >= 0 and len(palavras[j]) > len(atual):
        palavras[j + 1] = palavras[j]
        j -= 1
    palavras[j + 1] = atual
print(palavras)
print("mais curta:", palavras[0], "mais longa:", palavras[-1])
print("fim")O simulador repete na saída os valores digitados, um por linha, e depois vêm ['sol', 'uva', 'casa', 'abacaxi'], mais curta: sol mais longa: abacaxi e fim.
A única mudança em relação ao insertion sort de números é que a comparação usa len(palavras[j]) > len(atual), o tamanho das palavras, em vez das palavras em si. Como a comparação é estrita, sol e uva, que têm 3 letras, ficam na ordem em que foram digitadas: sol antes de uva. Esta é a estabilidade em ação.
Para treinar, tente: ordenar do maior ao menor, mudando só a comparação; ordenar em ordem alfabética sem usar o len; trocar o insertion pelo sorted(palavras, key=len) e ver, no simulador, se os empates saem na mesma ordem; e contar quantos deslocamentos foram feitos.
Perguntas frequentes
Por que o insertion sort é melhor em listas quase ordenadas? Porque cada elemento anda só até encontrar o seu lugar. Numa lista quase ordenada, a maioria já está no lugar e não anda nada. O trabalho é proporcional à desordem, como mostraram as 102 comparações para 100 elementos.
O insertion sort é estável? Com a comparação > estrita, sim: elementos iguais não passam um pelo outro. Se a comparação fosse >=, os iguais seriam deslocados à toa, e a ordem de entrada deixaria de ser preservada.
Por que o sorted() do simulador pode inverter os empates? Porque o simulador reproduz o algoritmo de ordenação do MicroPython, que não é estável, como explica o artigo sobre sorted com key. O Python de computador usa outro e é estável.
Devo usar sorted() ou sort()? O sorted() devolve uma lista nova e mantém a original. O sort() ordena a própria lista e devolve None. Escolha pela necessidade de guardar ou não a ordem original.
O insert é caro? Ele empurra todos os elementos seguintes uma casa para a direita, o que custa mais quanto maior a lista. Para as listas pequenas de uma placa, é perfeitamente aceitável.
Existe algo mais rápido que esses três algoritmos? Existe. O próximo artigo apresenta o merge sort e o quick sort, que dividem a lista em partes menores e ordenam muito mais rápido listas grandes.
Para continuar
Os desafios Busca na Lista, Maior da Lista e Lista ao Contrário praticam o percurso e o deslocamento de elementos que o insertion sort usa. Para rever a base, vale passar pelos artigos sobre listas, busca linear e binária, bubble e selection sort e lambda, map, filter e sorted, e pela trilha de lógica.
O próximo artigo trata do merge sort e do quick sort: o que significa dividir para conquistar, como a recursão entra na ordenação e por que esses algoritmos são mais rápidos em listas grandes.