Fundamentos
Dicionários em Python: chave, valor e contagens
Aprenda dicionários em Python: criar, ler com [] e get, alterar, percorrer com items, contar palavras, agrupar e a ordem dos itens no MicroPython.
Por Prof. Rodrigo Faustino · Atualizado em · 16 min de leitura
Um dicionário guarda valores que se encontram por uma chave, e não por uma posição. Em vez de perguntar "o que está no índice 2?", o programa pergunta "qual é a idade?", e o dicionário responde. Ele se escreve entre chaves, com pares chave: valor separados por vírgula, como em {"nome": "Ana", "idade": 20}. É a estrutura certa para registros, tabelas de consulta, configurações e, principalmente, contagens.
Nos artigos anteriores, a posição dizia o que cada item era: o primeiro, o último, o do índice 3. Isso funciona bem para uma sequência de valores do mesmo tipo e do mesmo significado, como notas ou leituras de sensor. Quando cada valor tem um papel próprio, ou quando a pergunta é "quantas vezes apareceu?", a chave é mais clara do que o número da posição. Este artigo mostra como criar, ler, alterar e percorrer dicionários, como contar e agrupar, uma diferença importante na ordem dos itens entre o simulador e o Python de computador, os erros mais comuns e usos na ESP32.
Criar um dicionário

vazio = {}
aluno = {"nome": "Ana", "idade": 20, "nota": 8.5}
print(vazio, aluno)
print(type(vazio), len(aluno))
print(aluno["nome"], aluno["idade"])
print(dict(a=1, b=2))
print(dict([("x", 1), ("y", 2)]))
print(dict(zip(["a", "b", "c"], [1, 2, 3])))
print(aluno.get("nome"))
print(aluno.get("peso"))
print(aluno.get("peso", 0))
print("nome" in aluno, "peso" in aluno, "Ana" in aluno)
print("fim")A saída tem {} e o dicionário aluno na primeira linha, depois <class 'dict'> 3, Ana 20, e as três formas de criar a partir de dict(...). Depois vêm Ana, None, 0 e True False False, e por fim fim. A ordem em que as chaves aparecem nas linhas que imprimem dicionários merece uma seção só dela, logo adiante.
O {} vazio cria um dicionário, e não um conjunto: o conjunto vazio tem outro nome, que o artigo sobre conjuntos mostra. A função dict(...) monta um dicionário de outras formas: com nomes (dict(a=1, b=2)), com uma lista de pares em tuplas, como as do artigo anterior, ou juntando duas listas com zip, uma de chaves e outra de valores. O len conta os pares.
Da ementa ao semestre planejado
- Plano de ensino e calendário montados sozinhos
- Diário de aulas pronto para colar no SIGA
- Slides e listas de exercícios com gabarito
Versão Community grátis · Windows
Ler um valor: [] e get
Há duas maneiras de ler, e a diferença entre elas é o que acontece quando a chave não existe. Com colchetes, aluno["idade"] devolve o valor, e uma chave ausente dá KeyError. Com o método get, aluno.get("peso") devolve None se a chave faltar, e aluno.get("peso", 0) devolve o valor padrão que você escolher, no caso o 0.
A pergunta "nome" in aluno testa as chaves. A última comparação do exemplo, "Ana" in aluno, deu False, porque "Ana" é um valor, e não uma chave. Para perguntar sobre valores, o caminho é "Ana" in aluno.values().
A escolha entre as duas leituras é de intenção. Se a chave tem de existir, e a ausência é um bug, os colchetes avisam alto com o erro. Se a ausência é normal, como ao contar ocorrências, o get evita o if.
Alterar: acrescentar, trocar e remover
Atribuir a uma chave nova acrescenta o par, e atribuir a uma chave que já existe troca o valor. Não há append, porque não há "fim" nem posição.
d = {"a": 1}
d["b"] = 2
d["a"] = 10
print(d)
d["c"] = 3
x = d.pop("c")
print(x, d)
print(d.pop("zzz", "nao tinha"))
del d["b"]
print(d)
d.update({"p": 5, "q": 6})
print(d)
d.update(a=99)
print(d)
print(d.setdefault("novo", 0))
print(d.setdefault("p", 100))
print(d)
d.clear()
print(d, len(d))
print("fim")A saída é {'a': 10, 'b': 2}, depois 3 {'a': 10, 'b': 2}, nao tinha, {'a': 10}, e as linhas do update, que são {'a': 10, 'q': 6, 'p': 5} e {'a': 99, 'q': 6, 'p': 5}. Em seguida aparecem 0, 5, {'a': 99, 'q': 6, 'p': 5, 'novo': 0}, {} 0 e fim.
O pop(chave) remove o par e devolve o valor, e com um segundo argumento (pop("zzz", "nao tinha")) devolve esse padrão em vez de dar erro. O del d["b"] remove sem devolver nada. O update junta os pares de outro dicionário ou de argumentos nomeados, trocando os que já existiam. O setdefault(chave, padrão) faz duas coisas: devolve o valor da chave se ela existir, e se não existir, cria com o padrão e devolve. Isso será útil para agrupar, mais adiante. O clear esvazia.
A ordem dos itens não é a de inserção
Olhe de novo as saídas acima. O dicionário do update foi montado como a, depois p, depois q, e foi impresso como a, q, p. Isso não é um defeito do simulador.
No Python de computador a partir da versão 3.7, um dicionário lembra a ordem em que os pares foram inseridos, e imprime nessa ordem. No MicroPython, que roda na ESP32, o dicionário é uma tabela de espalhamento (hash) e os itens aparecem na ordem em que a tabela os guarda, que depende das chaves e não da ordem de escrita. O simulador copia esse comportamento, e por isso as ordens que aparecem nos print e nos laços deste artigo são as do MicroPython e podem ser diferentes das que o seu Python de computador mostra.
A consequência prática é uma regra simples: nunca dependa da ordem das chaves de um dicionário. Se o programa precisa de uma ordem, ele a pede. O sorted(d) devolve as chaves em ordem alfabética, e o sorted(d.items(), key=...) ordena os pares por onde você mandar. Para ler um valor, a ordem não importa, porque a leitura é pela chave.
A IA que lembra da sua vida e mora no seu computador
- Memória de longo prazo com a fonte de cada resposta
- Funciona offline: seus dados ficam no seu PC
- Lê PDFs, slides, fotos e gravações de reunião
Plano Essencial grátis para sempre
Percorrer um dicionário
d = {"verde": 18, "amarelo": 19, "vermelho": 21}
for chave in d:
    print(chave)
print(list(d.keys()))
print(list(d.values()))
print(list(d.items()))
for nome, pino in d.items():
    print(nome, "->", pino)
print(sorted(d))
print(sorted(d.items(), key=lambda p: p[1], reverse=True))
print(sum(d.values()), max(d.values()), min(d, key=d.get))
print("fim")A saída começa com as chaves verde, vermelho e amarelo, uma por linha, na ordem da tabela do MicroPython. Em seguida vêm ['verde', 'vermelho', 'amarelo'], [18, 21, 19] e [('verde', 18), ('vermelho', 21), ('amarelo', 19)], e depois verde -> 18, vermelho -> 21 e amarelo -> 19. As últimas linhas são ['amarelo', 'verde', 'vermelho'], [('vermelho', 21), ('amarelo', 19), ('verde', 18)], 58 21 verde e fim.
Um for direto sobre o dicionário entrega as chaves. O keys() entrega só as chaves, o values() só os valores, e o items() entrega os pares, cada um como uma tupla. É por isso que o for nome, pino in d.items() funciona: a tupla (nome, pino) é desempacotada a cada volta, como no for x, y in pontos do artigo sobre tuplas. Essa é a forma mais comum de percorrer um dicionário.
As três últimas linhas mostram os parceiros de sempre. O sorted(d) ordena as chaves, e sorted(d.items(), key=lambda p: p[1], reverse=True) ordena os pares pelo valor, do maior para o menor, como no artigo sobre lambda, map, filter e sorted. O sum e o max aceitam os valores, e o min(d, key=d.get) devolve a chave do menor valor: o d.get serve de critério, e o resultado é verde, cujo pino 18 é o menor.
Uma observação: o keys(), o values() e o items() entregam visões, e não listas. Para ter uma lista, envolva com list(...), como no exemplo. Não dá para indexar uma visão, o que se vê nos erros adiante.
Contar: o uso mais valioso
Contar quantas vezes cada coisa aparece é o trabalho em que o dicionário brilha. A ideia é uma chave por coisa e, como valor, a contagem:
texto = "o gato e o rato e o gato"
contagem = {}
for palavra in texto.split():
    contagem[palavra] = contagem.get(palavra, 0) + 1
print(contagem)
for palavra, n in sorted(contagem.items(), key=lambda p: (-p[1], p[0])):
    print(palavra, n)
letras = {}
for c in "banana":
    letras[c] = letras.get(c, 0) + 1
print(letras)
print("fim")A saída é {'gato': 2, 'e': 2, 'o': 3, 'rato': 1}, depois as linhas o 3, e 2, gato 2 e rato 1, depois {'a': 3, 'n': 2, 'b': 1} e fim.
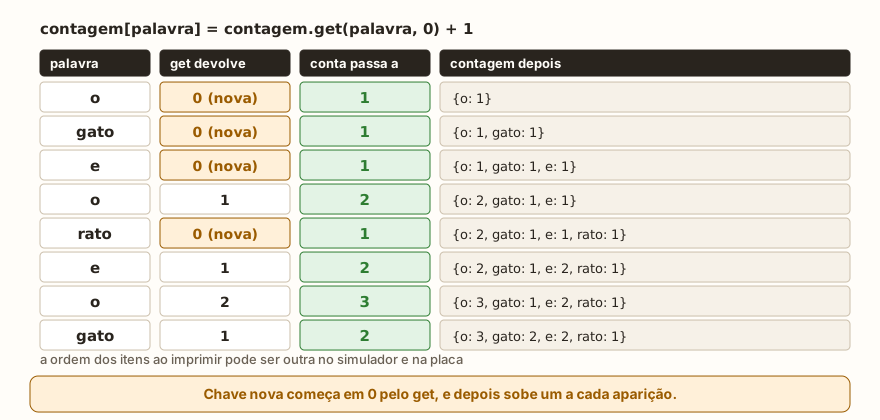
A linha contagem[palavra] = contagem.get(palavra, 0) + 1 é um padrão para decorar. O get(palavra, 0) devolve a contagem atual, ou 0 se a palavra ainda não apareceu, e o + 1 soma a ocorrência de agora. O resultado é guardado na mesma chave. A figura mostra o dicionário crescendo palavra por palavra.
O texto.split() separa o texto em palavras e devolve uma lista, o que será visto em detalhe no artigo sobre strings. O "banana" do segundo caso mostra que o for sobre um texto entrega letra por letra, e que o mesmo molde conta letras.
A ordenação final merece um olhar. A chave (-p[1], p[0]) é uma tupla: primeiro o negativo da contagem, para que o maior fique na frente, e depois a palavra, para desempatar em ordem alfabética. É a chave composta do artigo sobre sorted, e garante uma saída previsível quando duas palavras empatam, como e e gato, ambas com 2. Sem o desempate, a ordem dos empatados dependeria da tabela do dicionário.
O erro clássico dessa conta é escrever só contagem[palavra] += 1, sem o get. Na primeira vez que uma palavra aparece, a chave não existe e o resultado é KeyError. As duas saídas são o get com padrão, como acima, ou o teste if palavra in contagem.
Agrupar: um dicionário de listas
Outro uso é guardar, para cada chave, uma lista de itens. É o caso de agrupar alunos por turma, leituras por sensor ou eventos por tipo:
alunos = [("Ana", "A"), ("Bia", "B"), ("Caio", "A"), ("Duda", "B"), ("Edu", "A")]
turmas = {}
for nome, turma in alunos:
    turmas.setdefault(turma, []).append(nome)
print(turmas)
turmas2 = {}
for nome, turma in alunos:
    if turma not in turmas2:
        turmas2[turma] = []
    turmas2[turma].append(nome)
print(turmas2 == turmas)
print("fim")A saída é {'A': ['Ana', 'Caio', 'Edu'], 'B': ['Bia', 'Duda']}, True e fim. O for nome, turma in alunos desempacota cada tupla. O turmas.setdefault(turma, []) devolve a lista da turma, criando uma lista vazia quando a turma é nova, e o .append(nome) acrescenta à lista devolvida. A segunda forma faz o mesmo com um if, e a comparação turmas2 == turmas mostra que o resultado é igual. A forma com setdefault é mais curta, e a com if é mais fácil de ler quando se está começando.
Cópia e compreensão de dicionário
O dicionário é mutável, como a lista, e a atribuição b = a também só cria outro nome para o mesmo dicionário:
a = {"x": 1}
b = a
b["y"] = 2
print(a, b, a is b)
c = a.copy()
c["z"] = 3
print(a, c, a is c)
print({n: n * n for n in range(4)})
d = {"a": 1, "b": 2}
print({v: k for k, v in d.items()})
print({k: v for k, v in d.items() if v > 1})
print({(0, 0): "origem", (3, 4): "ponto"}[(3, 4)])
duplicada = {"a": 1, "a": 2}
print(duplicada)
print("fim")A saída é {'y': 2, 'x': 1} {'y': 2, 'x': 1} True, depois {'y': 2, 'x': 1} {'y': 2, 'x': 1, 'z': 3} False, {0: 0, 1: 1, 2: 4, 3: 9}, {2: 'b', 1: 'a'}, {'b': 2}, ponto, {'a': 2} e fim.
As duas primeiras linhas repetem a lição do artigo sobre listas: depois de b = a, mexer em b muda a, e o is confirma que só há um dicionário. O copy() cria outro, e os dois passam a mudar de forma independente. A cópia é rasa: valores que são listas continuam compartilhados entre as duas cópias.
As três linhas seguintes são compreensões de dicionário, a versão com chaves das compreensões de lista do artigo sobre operações com listas. A forma é {chave: valor for ... in ...}, com if opcional no fim. A primeira cria uma tabela de quadrados, a segunda inverte um dicionário, trocando chaves por valores, e a terceira filtra só os pares cujo valor passa no teste. Inverter só funciona quando os valores são todos diferentes: se dois valores forem iguais, o último ganha, e um par some.
O penúltimo exemplo mostra que uma tupla serve de chave. A tupla (3, 4) leva ao texto ponto, como o artigo anterior antecipou, e é assim que se guarda algo indexado por coordenada. A lista, por ser mutável, não serve de chave, e o erro está na seção de erros.
O último caso mostra uma chave repetida: {"a": 1, "a": 2} não dá erro, e fica o último valor. Isso explica uma surpresa comum: se o dicionário parece ter menos itens do que você escreveu, procure uma chave duplicada.
Lista de dicionários: registros
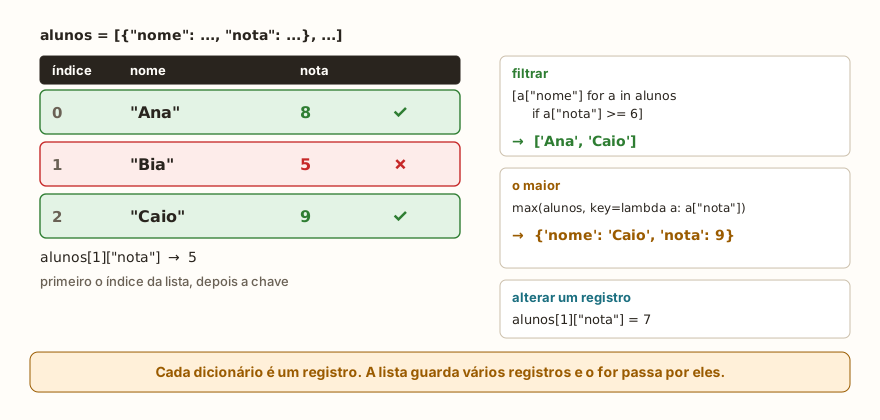
Quando cada item de uma coleção tem vários campos, o formato mais natural é uma lista em que cada item é um dicionário. Cada dicionário é um registro, e o conjunto todo é uma pequena tabela:
alunos = [
    {"nome": "Ana", "nota": 8},
    {"nome": "Bia", "nota": 5},
    {"nome": "Caio", "nota": 9},
]
for a in alunos:
    print(a["nome"], a["nota"])
aprovados = [a["nome"] for a in alunos if a["nota"] >= 6]
print(aprovados)
media = sum(a["nota"] for a in alunos) // len(alunos)
print(media)
melhor = max(alunos, key=lambda a: a["nota"])
print(melhor)
alunos[1]["nota"] = 7
print(alunos[1])
print("fim")A saída é Ana 8, Bia 5, Caio 9, ['Ana', 'Caio'], 7, {'nome': 'Caio', 'nota': 9}, {'nome': 'Bia', 'nota': 7} e fim. O for a in alunos entrega um dicionário por volta, e a["nome"] lê o campo. O filtro e o max com key seguem os moldes do artigo anterior, só que agora a conta é feita com a["nota"]. Para trocar um campo, primeiro o índice da lista e depois a chave: alunos[1]["nota"] = 7.
Esse formato, lista de dicionários, tem a mesma cara dos dados em JSON, que aparece mais abaixo.
Na ESP32: tabelas de consulta, configuração e leituras
Um dicionário vira uma tabela de consulta quando faz o papel de uma cadeia de if e elif. Em vez de testar cada nome de cor e escolher o pino, o programa guarda o pino em um dicionário e lê pela chave:
from machine import Pin
from time import sleep

LEDS = {
    "verde": Pin(18, Pin.OUT),
    "amarelo": Pin(19, Pin.OUT),
    "vermelho": Pin(21, Pin.OUT),
}
sequencia = ["verde", "amarelo", "vermelho", "amarelo"]
for cor in sequencia:
    LEDS[cor].on()
    sleep(0.1)
    LEDS[cor].off()
print(len(LEDS), list(LEDS))

CONFIG = {"intervalo": 5, "limite": 30, "modo": "auto"}
leitura = {"temp": 24, "umid": 61}
if leitura["temp"] < CONFIG["limite"]:
    print("temperatura normal")
leitura["alerta"] = leitura["temp"] >= CONFIG["limite"]
print(leitura)
print("fim")A saída é 3 ['verde', 'vermelho', 'amarelo'], temperatura normal, {'umid': 61, 'temp': 24, 'alerta': False} e fim. O dicionário LEDS guarda objetos Pin como valores, e a sequência de cores, que pode ter a ordem e as repetições que você quiser, é percorrida pelo nome de cada LED. Trocar a ordem do semáforo vira editar a lista sequencia, e não o código do laço. O dicionário CONFIG junta as configurações num só lugar, com nomes que se explicam sozinhos, e a leitura é um registro que ganha um campo alerta calculado a partir de outros dois.
Note que list(LEDS) e leitura aparecem com os itens fora da ordem de escrita, o que repete o aviso da seção sobre ordem.
Um dicionário também vira texto para viajar pela rede. O módulo json converte nos dois sentidos:
import json
leitura = {"temp": 24, "umid": 61}
texto = json.dumps(leitura)
print(texto, type(texto))
volta = json.loads(texto)
print(volta, volta["temp"])
print("fim")A saída é {"umid": 61, "temp": 24} <class 'str'>, {'umid': 61, 'temp': 24} 24 e fim. O json.dumps transforma o dicionário em um texto e o json.loads o transforma de volta. É assim que as leituras costumam ser enviadas por HTTP ou por MQTT, como no artigo sobre Wi-Fi, HTTP e MQTT na ESP32. Repare que o texto também sai na ordem da tabela, que não é a de escrita, e quem lê do outro lado recebe os campos pelos nomes, então a ordem não importa.
Erros comuns
As mensagens abaixo são as do simulador, que imita o MicroPython. Em alguns casos o texto é diferente do do Python de computador, e eu aponto quando é.
d = {"nome": "Ana"}
print(d["idade"])KeyError: idadeA chave não existe. O simulador mostra o nome sem aspas, e o Python de computador escreve KeyError: 'idade'. A cura é decidir se a ausência é um erro, e então manter os colchetes, ou se é normal, e então usar get ou in.
d = {"a": 1}
d["b"] += 1KeyError: bO += lê a chave antes de somar, e a chave b não existe. É o erro mais comum nas contagens, e se resolve com d["b"] = d.get("b", 0) + 1.
d = {"a": 1}
d.append(2)AttributeError: 'dict' object has no attribute 'append'O dicionário não tem append, porque não tem posição. Para acrescentar, atribua a uma chave nova.
d = {"a": 1}
print(d[0])KeyError: 0O índice de uma lista não funciona num dicionário. O 0 aqui é tratado como uma chave, e não como a posição. Quem espera "o primeiro item" precisa de list(d)[0], lembrando que a ordem não é a da escrita.
d = {"a": 1}
print(d.get("x").upper())AttributeError: 'NoneType' object has no attribute 'upper'O get sem padrão devolveu None, e o .upper() foi chamado sobre ele. Dê um padrão do tipo certo, como d.get("x", ""), ou teste antes.
d = {"a": 1, "b": 2}
for k, v in d:
print(k, v)ValueError: need more than 1 values to unpackO for sobre o dicionário entrega só as chaves, e o k, v tenta abrir cada chave em dois nomes. Aqui as chaves têm uma letra só, e a mensagem diz que falta valor. Com chaves mais longas, o erro seria outro, de excesso, porque o texto seria aberto letra por letra. A correção é sempre d.items().
d = {[1, 2]: "x"}TypeError: unsupported type for __hash__: 'list'Uma lista não pode ser chave, porque pode mudar. A tupla (1, 2) pode. O Python de computador diz unhashable type: 'list'.
d = {"a": 1}
print(d.keys()[0])TypeError: 'dict_view' object isn't subscriptableA visão que o keys() entrega não aceita índice. Use list(d.keys())[0].
Há ainda um caso que no Python de computador dá RuntimeError: dictionary changed size during iteration: acrescentar chaves a um dicionário enquanto se percorre esse mesmo dicionário. No simulador, o laço de teste terminou sem erro, e mesmo assim o comportamento não deve ser usado, assim como apagar itens de uma lista dentro de um for. O caminho seguro é percorrer uma cópia, como for k in list(d):, ou montar um dicionário novo.
O que costuma aparecer em sala
Estes padrões se repetem em turmas de todos os níveis.
O primeiro é o KeyError numa contagem: o aluno escreve contagem[x] += 1, o programa funciona no primeiro teste porque a chave já estava lá, e quebra no segundo. A pergunta que resolve é "e na primeira vez que essa palavra aparece, o que o dicionário tem?".
O segundo é o d[0] esperando "o primeiro item". Quem vem das listas traz o hábito de perguntar por posição, e o dicionário responde com um KeyError: 0 que parece estranho.
O terceiro é esperar a ordem de escrita. No computador ela quase sempre vale, e na ESP32 não. Um programa que funciona na máquina e imprime os campos em outra ordem na placa é um sintoma típico, e a cura é pedir a ordem com sorted.
O quarto é a confusão entre in com chaves e com valores. O teste "Ana" in aluno dá False e o aluno jura que Ana está lá. Ela está, só que como valor.
O quinto é o for k, v in d sem o .items(), visto acima.
O sexto é a chave repetida, que some em silêncio: o aluno escreve dois itens com a mesma chave, e o primeiro desaparece.
O sétimo é achar que b = a copia o dicionário, que é a mesma pegadinha das listas, e costuma aparecer em quem acabou de aprender a diferença para as listas e acha que o dicionário "é diferente".
Exercício: palavras mais comuns
Escreva um programa que pergunte quantas palavras serão lidas, leia cada uma, conte quantas vezes cada palavra aparece e mostre a quantidade de palavras distintas, cada palavra com sua contagem, da mais frequente para a menos, e qual é a mais comum.
quantidade = int(input("quantas palavras: "))
contagem = {}
for i in range(quantidade):
    palavra = input("palavra: ")
    contagem[palavra] = contagem.get(palavra, 0) + 1
print("distintas", len(contagem))
ordenadas = sorted(contagem.items(), key=lambda p: (-p[1], p[0]))
for palavra, n in ordenadas:
    print(palavra, n)
print("mais comum", ordenadas[0][0])Com as entradas 8, o, gato, e, o, rato, e, o e gato, as linhas finais são distintas 4, o 3, e 2, gato 2, rato 1 e mais comum o. O ordenadas[0][0] é o primeiro par da lista, e dentro dele a palavra. Para treinar, mostre também as palavras que aparecem uma só vez, e faça o programa ignorar maiúsculas e minúsculas, aplicando .lower() a cada palavra antes de contar. Depois, troque a leitura palavra a palavra por uma frase inteira com input().split(), que o artigo sobre strings explica. O que acontece se o usuário digitar 0 como quantidade? Teste e proteja o programa.
Perguntas frequentes
Quando uso dicionário e quando uso lista? Use lista quando a posição ou a ordem é o que importa, e os itens são do mesmo tipo. Use dicionário quando cada valor tem um nome, ou quando você precisa achar algo pelo nome rapidamente.
A chave pode ser um número? Pode. Números, textos e tuplas servem. Listas e outros dicionários, não, porque podem mudar.
O dicionário é mais rápido que a lista para procurar? Procurar uma chave num dicionário não percorre os itens um a um, e é por isso que ele é a estrutura para consultas. Este artigo não mediu tempos na ESP32.
Qual a diferença entre d["x"] e d.get("x")? Os colchetes dão KeyError quando a chave não existe, e o get devolve None ou o padrão que você pedir.
Como junto dois dicionários? Com update, que altera o primeiro, e que troca os valores das chaves repetidas. A soma d1 + d2 não existe e dá TypeError.
Para continuar
O desafio Busca em Vetor trabalha a ideia de procurar um valor, que o dicionário resolve por chave. Para rever as bases, os artigos sobre listas, operações com listas e tuplas completam este.
O próximo artigo trata dos conjuntos: coleções sem repetição, que respondem em uma linha a perguntas como "quais itens estão nas duas listas" e "quais aparecem só em uma".