Fundamentos
Strings a fundo em Python: fatiamento e métodos mais usados
Domine as strings em Python: índices e fatias, imutabilidade, split, join, replace, find, formatação, e o que o MicroPython da ESP32 não tem.
Por Prof. Rodrigo Faustino · Atualizado em · 15 min de leitura
Uma string, ou texto, é uma sequência de caracteres. Como a lista e a tupla, ela tem índice, fatia e len, e se percorre com for. Diferente da lista, ela não pode ser alterada no lugar: todo método de texto devolve um texto novo e deixa o original como estava. A maior parte do trabalho com strings é saber quais métodos existem, o que cada um devolve e como juntar poucos deles para resolver problemas reais, como limpar o que o usuário digitou, separar os campos de uma mensagem ou alinhar números numa tela.
Os artigos anteriores já usaram o texto de várias formas: print e input, a conversão com str() e int(), strip e isdigit para validar, as f-strings. Aqui o assunto ganha o espaço próprio. Veremos os índices e as fatias, a imutabilidade, os métodos mais usados em grupos, a formatação, os caracteres e as sequências de escape, algumas receitas, usos na ESP32, e uma parte importante: vários métodos de texto do Python de computador não existem no MicroPython, e o simulador, que o imita, reproduz essa falta.
Texto é uma sequência

texto = "Python"
print(texto[0], texto[1], texto[-1], texto[-2])
print(texto[1:4], texto[:2], texto[3:], texto[:])
print(texto[2:100], repr(texto[4:1]))
print(len(texto), texto + "!", texto * 2)
print("th" in texto, "ht" in texto, "Py" in texto)
for letra in texto:
    print(letra, end="-")
print()
print(ord("A"), ord("a"), chr(66), chr(97))
print("a" < "b", "B" < "a", "casa" < "casaco", "10" < "9")
print("fim")A saída é P y n o, yth Py hon Python, thon '', 6 Python! PythonPython, True False True, P-y-t-h-o-n-, 65 97 B a, True True True True e fim.
Tudo o que o artigo sobre listas disse sobre índices e fatias vale aqui: o primeiro caractere está no índice 0, o -1 é o último, texto[1:4] vai do índice 1 até antes do 4, e uma fatia fora dos limites não dá erro. A diferença está no resultado: a fatia de um texto é outro texto, e a de uma lista é outra lista.
O operador in aplicado a texto procura um pedaço, e não só um caractere. "th" in "Python" dá True, e "ht" dá False, porque a ordem importa. O + junta textos, e o * repete.
As duas últimas linhas lembram que o computador guarda cada caractere como um número. O ord("A") devolve 65, e o chr(66) devolve B. A comparação entre textos usa esses números, caractere a caractere, e por isso "B" < "a" é verdadeiro, já que as maiúsculas vêm antes das minúsculas na tabela. E "10" < "9" também, porque o "1" vem antes do "9": comparar números escritos como texto dá ordem alfabética, e não numérica. É o mesmo cuidado que o artigo sobre conversão de tipos pediu ao ler dados do teclado.
A fatia com passo não funciona no simulador
No Python de computador, texto[::-1] é a receita mais conhecida para inverter um texto. No simulador, que imita o MicroPython, a fatia de texto com passo diferente de 1 não existe, como já acontecia com a tupla:
texto = "Python"
print(texto[::-1])NotImplementedError: only slices with step=1 (aka None) are supportedA solução é pedir ao reversed, que percorre de trás para frente, e juntar o resultado:
texto = "Python"
print("".join(reversed(texto)))
print("".join(reversed("abc")))
print(list(texto)[::-1])
print("".join(list(texto)[::-1]))
print(texto[::1])
print(texto[0:6:1])
print("fim")A saída é nohtyP, cba, ['n', 'o', 'h', 't', 'y', 'P'], nohtyP, Python, Python e fim. O "".join(reversed(texto)) é o caminho mais curto. A lista aceita a fatia com passo, e por isso list(texto)[::-1] funciona, mas a fatia direta no texto, só com o passo 1.
A IA que lembra da sua vida e mora no seu computador
- Memória de longo prazo com a fonte de cada resposta
- Funciona offline: seus dados ficam no seu PC
- Lê PDFs, slides, fotos e gravações de reunião
Plano Essencial grátis para sempre
O texto não muda: os métodos devolvem outro
Tentar trocar uma letra dá erro, e os métodos de transformação, como o upper, não alteram a variável:
s = "Ana"
print(s.upper(), s)
t = s.upper()
print(t, s)
print("a" + "b" * 3, "ab" "cd")
print("=" * 10)
print("Python".lower().startswith("py"), "x".join("abc"))
print("fim")A saída é ANA Ana, ANA Ana, abbb abcd, uma linha de dez sinais de igual, True axbxc e fim. O s.upper() entregou ANA, e a variável s continuou Ana. Para guardar o resultado é preciso atribuir, como em t = s.upper(), ou s = s.upper() se o original não for mais necessário. Os métodos se encadeiam: "Python".lower().startswith("py") primeiro baixa as letras e depois pergunta pelo começo. O "x".join("abc") usa o x como separador entre as letras de abc, e o "ab" "cd" mostra que dois textos escritos lado a lado se juntam sozinhos.
Os métodos mais usados
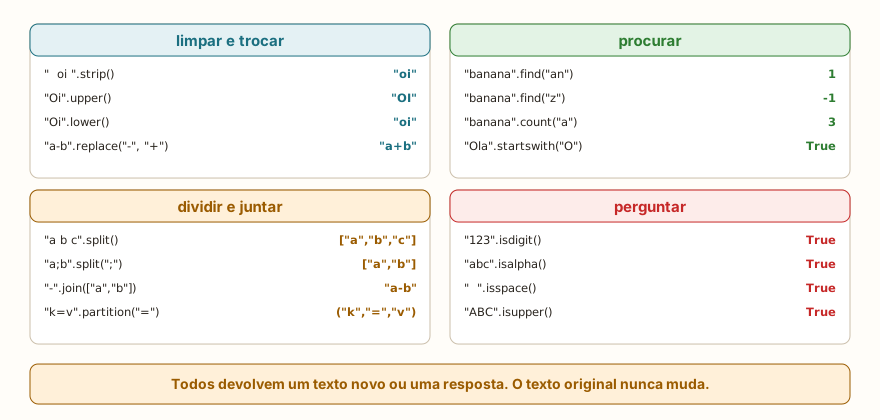
Os métodos que existem no simulador cabem em quatro famílias. A figura traz um exemplo de cada um, e o exemplo abaixo roda os principais:
s = "  Ola, Mundo  "
print(repr(s.strip()), repr(s.lstrip()), repr(s.rstrip()))
t = "Ola, Mundo"
print(t.upper(), t.lower())
print(t.replace("o", "0"), t.replace("o", "0", 1))
print(t.find("o"), t.find("z"), t.rfind("o"), t.count("o"))
print(t.index("M"))
print(t.startswith("Ola"), t.endswith("do"), t.startswith("ola"))
print(t.split(","), t.split())
print("a;b;c".split(";"), "a;b;c".split(";", 1))
print("-".join(["a", "b", "c"]), "".join(["x", "y"]), ", ".join(["1", "2"]))
print("fim")A saída é 'Ola, Mundo' 'Ola, Mundo ' ' Ola, Mundo', depois OLA, MUNDO ola, mundo, Ola, Mund0 Ola, Mund0, 9 -1 9 1, 5, True True False, ['Ola', ' Mundo'] ['Ola,', 'Mundo'], ['a', 'b', 'c'] ['a', 'b;c'], a-b-c xy 1, 2 e fim.
Limpar e trocar. O strip tira os espaços das duas pontas, o lstrip só os da esquerda e o rstrip só os da direita. O repr foi usado para mostrar os espaços que sobram. O upper e o lower mudam a caixa. O replace(antigo, novo) troca todas as ocorrências, e um terceiro argumento limita quantas.
Procurar. O find devolve a posição da primeira ocorrência, ou -1 se não houver, e o rfind procura a partir do fim. O index faz o mesmo que o find, mas dá erro se não achar. O count conta as ocorrências, sem sobrepor. Repare que o t.count("o") deu 1, e não 2: o O maiúsculo de Ola não é um o, e a busca diferencia maiúsculas de minúsculas. O startswith e o endswith perguntam pelo começo e pelo fim.
Dividir e juntar. O split(sep) corta o texto em uma lista. Sem argumento, ele corta em qualquer sequência de espaços, e é por isso que t.split() deu ['Ola,', 'Mundo']. Com um separador, como ",", ele corta exatamente ali e conserva os espaços, e o segundo item ficou ' Mundo', com o espaço na frente. Um segundo argumento limita o número de cortes. O join faz o contrário: o separador vem antes do ponto, e a lista, entre parênteses: "-".join(lista). Os itens da lista precisam ser textos.
Mais dois que cabem aqui, e a lista de perguntas sobre o conteúdo:
print("123".isdigit(), "12a".isdigit(), "abc".isalpha(), "ab1".isalpha())
print("   ".isspace(), "ABC".isupper(), "abc".islower(), "Abc".isupper(), "Abc".islower())
print("ab".center(6) + "|")
print("a,b,c".partition(","), "a,b,c".rpartition(","))
print("a b c d".rsplit(" ", 1), "a b c d".split(" ", 1))
print("linha1\nlinha2".splitlines())
print("banana".rfind("an"), "banana".find("an"), "banana".rindex("a"))
print("fim")A saída é True False True False, True True True False False, ab |, ('a', ',', 'b,c') ('a,b', ',', 'c'), ['a b c', 'd'] ['a', 'b c d'], ['linha1', 'linha2'], 3 1 5 e fim.
Perguntar. O isdigit, o isalpha, o isspace, o isupper e o islower dão True ou False. Atenção: elas são verdadeiras só quando todos os caracteres passam, e o texto vazio não passa. "Abc".isupper() e "Abc".islower() dão False os dois, porque o texto tem as duas caixas. O partition(sep) corta uma vez e devolve três partes numa tupla: antes, o separador e depois, e o rpartition corta na última ocorrência. O splitlines separa por quebras de linha. O center(6) centraliza o texto numa largura, e aqui, no simulador, aceita só a largura, sem o caractere de preenchimento.
O que o computador tem e a placa não
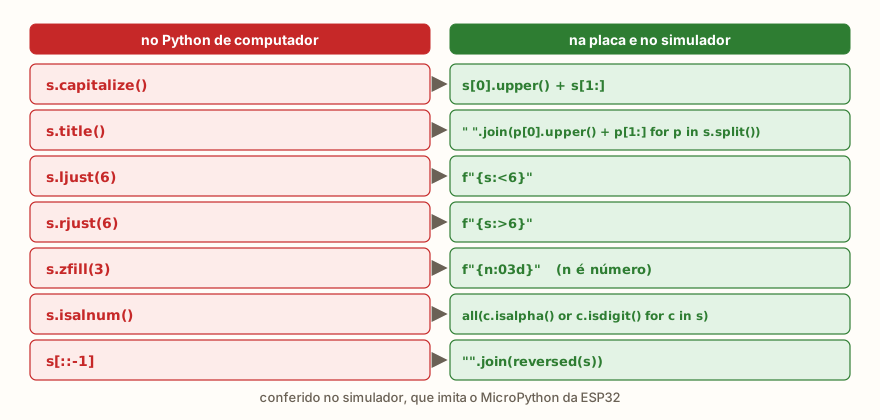
Se você aprendeu métodos de texto num curso de Python para computador, vai esbarrar em uma surpresa: vários métodos que parecem básicos não existem no MicroPython. No simulador, os seguintes dão AttributeError: capitalize, title, swapcase, casefold, ljust, rjust, zfill, isalnum, isidentifier, istitle, removeprefix, removesuffix, translate e format_map, entre outros. Todos existem no Python de computador. A figura mostra o que escrever no lugar dos mais usados, e o exemplo abaixo confirma:
frase = "a ordem dos fatores"
palavras = frase.split()
print(len(palavras), palavras)
print([p[0].upper() + p[1:] for p in palavras])
print(" ".join(p[0].upper() + p[1:] for p in palavras))
print("".join(p[0] for p in palavras))
s = "7"
print("0" * (3 - len(s)) + s, f"{7:03d}")
nome = "ana"
print(nome[0].upper() + nome[1:])
print(f"{'ab':>5}|{'ab':<5}|{'ab':^5}|")

def so_letras_e_digitos(t):
    return all(c.isalpha() or c.isdigit() for c in t)

print(so_letras_e_digitos("ab1"), so_letras_e_digitos("ab 1"))
print("fim")A saída é 4 ['a', 'ordem', 'dos', 'fatores'], ['A', 'Ordem', 'Dos', 'Fatores'], A Ordem Dos Fatores, aodf, 007 007, Ana, ab|ab | ab |, True False e fim.
O substituto da primeira letra maiúscula é t[0].upper() + t[1:]. Para o title, junta-se a mesma conta em cada palavra do split. Para alinhar à esquerda, à direita ou ao centro, a f-string resolve com :<, :> e :^. Para completar com zeros à esquerda, o :03d faz o trabalho de zfill em números, e "0" * (3 - len(s)) + s faz em textos. O que o isalnum perguntaria vira um all sobre os caracteres.
A regra de ouro é testar o método no simulador antes de usá-lo num programa para a placa. Se aparecer AttributeError: 'str' object has no attribute ..., o método não existe, e a lista acima dá o caminho.
Da ementa ao semestre planejado
- Plano de ensino e calendário montados sozinhos
- Diário de aulas pronto para colar no SIGA
- Slides e listas de exercícios com gabarito
Versão Community grátis · Windows
Formatar textos
As f-strings já foram apresentadas no artigo sobre print e input. Aqui, o resumo das opções de formato, e as duas formas mais antigas, que ainda aparecem em código por aí:
nome = "Ana"
idade = 20
nota = 8.5
print(f"{nome} tem {idade} anos")
print(f"{nota:.2f} | {idade:5d}| {idade:<5d}| {idade:05d}")
print(f"{nome:>6}|{nome:<6}|{nome:^7}|")
print("{} tem {} anos".format(nome, idade))
print("{0} e {1} e {0}".format("a", "b"))
print("%s tem %d anos" % (nome, idade))
print("%.1f%%" % 45.5)
print(f"{255:x} {255:X} {5:08b}")
print(f"{'aspas'} {nome!r}")
print("fim")A saída é Ana tem 20 anos, 8.50 | 20| 20 | 00020, Ana|Ana | Ana |, Ana tem 20 anos, a e b e a, Ana tem 20 anos, 45.5%, ff FF 00000101, 'aspas' 'Ana' e fim.
Depois dos dois pontos vem a especificação: .2f dá duas casas decimais, 5d reserva cinco posições para um inteiro, <, > e ^ alinham à esquerda, à direita e ao centro, 05d completa com zeros, e x, X e b escrevem em hexadecimal e em binário. O !r mostra o repr, com as aspas. O método format usa {} no texto e recebe os valores nos parênteses, com ou sem números de posição, e o operador % usa %s, %d e %f. As três formas dão o mesmo resultado, e a f-string é a mais legível. Se você usar :d com um texto, o erro é ValueError, como se vê adiante.
Caracteres especiais, aspas e acentos
print("linha1\nlinha2")
print("coluna1\tcoluna2")
print("barra \\ e aspas \" e '")
print('aspas "duplas" dentro')
print("""varias
linhas""")
print(r"c:\novo")
print(len("ação"), "ação"[2], "ação".upper())
print("ç" < "d", ord("ç"))
print(len("a\nb"))
print("fim")A saída é linha1 e linha2 em duas linhas, coluna1 e coluna2 separadas por tabulação, barra \ e aspas " e ', aspas "duplas" dentro, varias e linhas em duas linhas, c:\novo, 4 ã AçãO, False 231, 3 e fim.
A barra invertida inicia uma sequência de escape: \n é a quebra de linha, \t é a tabulação, \\ é uma barra e \" é uma aspa dentro de um texto delimitado por aspas. O texto entre aspas simples pode ter aspas duplas dentro, e o contrário. As aspas triplas guardam o texto em várias linhas. O prefixo r (de raw, cru) desliga os escapes, e é útil para caminhos do Windows como c:\novo, em que o \n não é quebra de linha. O texto "a\nb" tem 3 caracteres, porque a quebra conta como um.
Com acentos, o simulador conta os caracteres do jeito esperado: len("ação") dá 4, e "ação"[2] é o ã. Mas há uma pegadinha nas duas últimas contas: "ação".upper() devolveu AçãO, com ç e ã intactos. No MicroPython, upper e lower só trocam as letras sem acento. No Python de computador, o resultado seria AÇÃO. A comparação "ç" < "d" também deu False, porque o código de ç é 231, bem maior que o de d, e por isso ordenar palavras acentuadas pela comparação direta não segue a ordem alfabética do português. Se o programa precisa ignorar maiúsculas em texto com acento, trate as letras acentuadas à mão, ou evite depender disso.
Receitas com texto
Alguns problemas clássicos mostram os métodos trabalhando juntos:
def eh_palindromo(t):
    t = t.lower().replace(" ", "")
    return t == "".join(reversed(t))

print(eh_palindromo("Ana"), eh_palindromo("Python"), eh_palindromo("A base do teto desaba"))

def cesar(t, k):
    r = ""
    for c in t:
        if "a" <= c <= "z":
            r += chr((ord(c) - ord("a") + k) % 26 + ord("a"))
        else:
            r += c
    return r

print(cesar("abc xyz", 3), cesar(cesar("abc xyz", 3), -3))
vogais = 0
for c in "programacao":
    if c in "aeiou":
        vogais += 1
print(vogais)
print("fim")A saída é True False True, def abc abc xyz e 5, seguidos de fim. O palíndromo (texto que se lê igual nos dois sentidos) baixa as letras, tira os espaços e compara o texto com o seu inverso, e a inversão usa o join com reversed que vimos. A cifra de César desloca cada letra k posições no alfabeto: ord(c) - ord("a") dá a posição de 0 a 25, a soma com k e o % 26 dão a volta no alfabeto, e o chr converte de volta. Os caracteres fora de a a z, como o espaço, passam sem mudar, e aplicar a cifra com -3 desfaz a de 3. O contador de vogais usa o in para testar se a letra está em "aeiou". Atenção: o exemplo da cifra e o das vogais só tratam letras minúsculas sem acento.
Na ESP32: mensagens, comandos e colunas
Em projetos com a placa, o texto chega de fora em formatos simples: uma linha com campos separados, um comando digitado, uma resposta de sensor. O split e o startswith resolvem a maioria:
mensagem = "temp=24;umid=61;modo=auto"
dados = {}
for par in mensagem.split(";"):
    chave, valor = par.split("=")
    dados[chave] = valor
print(sorted(dados.items()))
temp = int(dados["temp"])
print(temp + 1)
comando = "LED ON"
if comando.startswith("LED"):
    estado = comando.split()[1]
    print("estado", estado)
nomes = ["Temp", "Umid"]
valores = [24, 61]
for nome, v in zip(nomes, valores):
    print(f"{nome:<6}{v:>4}")
print(f"{24:>3}C {61:>3}%")
print("fim")A saída é [('modo', 'auto'), ('temp', '24'), ('umid', '61')], 25, estado ON, Temp 24, Umid 61, 24C 61% e fim. O primeiro bloco quebra a mensagem em pares com split(";"), abre cada par em chave e valor com split("="), e guarda num dicionário, como o artigo sobre dicionários apresentou. Os valores continuam textos, e o int(...) converte o que for número. O sorted na impressão evita depender da ordem do dicionário. O segundo bloco lê um comando: startswith("LED") reconhece a família e split()[1] pega a palavra seguinte. O terceiro monta colunas alinhadas com a f-string, o que é útil numa tela como a do artigo sobre I2C com OLED e LCD, em que cada linha tem largura fixa.
Erros comuns
As mensagens abaixo são as do simulador, que imita o MicroPython. O tipo do erro costuma ser o mesmo no Python de computador, e o texto pode mudar.
s = "Python"
s[0] = "J"TypeError: 'str' object doesn't support item assignmentO texto não aceita troca de letra. O jeito é montar outro: "J" + s[1:].
s = "Python"
print(s[6])IndexError: string index out of rangeO texto tem 6 caracteres, e os índices vão de 0 a 5. É o mesmo erro do lista[len(lista)].
print("idade: " + 20)TypeError: unsupported types for __add__: 'str', 'int'O + entre texto e número não é uma conta válida. Use str(20), a vírgula do print ou uma f-string.
print("abc".index("z"))ValueError: substring not foundO index dá erro quando o pedaço não existe. O find devolve -1, e é a escolha quando a ausência é normal.
print("a,b".split(",")[2])IndexError: list index out of rangeO split devolveu uma lista de dois itens, e o índice 2 não existe. O erro aparece na lista, e não no texto.
print(",".join([1, 2, 3]))TypeError: join expects a list of str/bytes objects consistent with self objectO join só junta textos. Converta antes: ",".join([str(n) for n in lista]).
x, y = "a=b=c".split("=")ValueError: too many values to unpack (expected 2)O split encontrou dois sinais de igual e devolveu três partes. Para cortar só na primeira, use split("=", 1).
print(f"{'x':d}")ValueError: unknown format code 'd' for object of type 'str'O formato d é para inteiros. Num texto, o formato correto é o s, ou nenhum.
print("abc"[1.5])TypeError: string indices must be integers, not floatO índice precisa ser inteiro, como na lista. A causa costuma ser uma divisão com /, e a correção, o //.
O que costuma aparecer em sala
Estes padrões se repetem em turmas de todos os níveis.
O primeiro é escrever s.upper() sozinho numa linha e achar que s mudou. Não dá erro, e a linha não faz nada: o resultado é descartado. A outra variante é s.strip() antes de um if, e depois testar a variável original. Toda vez que um método de texto "não funciona", a primeira pergunta é se o resultado foi guardado.
O segundo é o + com número, visto acima, que continua sendo o erro mais frequente de quem acabou de aprender o input.
O terceiro é a comparação de números escritos como texto. "10" < "9" dá True, e sorted(["10", "9", "100"]) ordena como dicionário, e não como número. A cura é converter com int antes de comparar.
O quarto é o split(",") em dados que têm espaços, que deixa os espaços colados nos itens, e o programa deixa de reconhecer "b" porque o item é " b". O strip em cada item resolve.
O quinto é procurar com in e depois usar o index sem lembrar que o texto pode aparecer mais de uma vez, ou com outra caixa. "Python" e "python" são textos diferentes, e a busca diferencia.
O sexto é levar os métodos do computador para a placa. O programa roda no PC, e no simulador ou na ESP32 o title ou o zfill dão AttributeError. É o tipo de erro que só aparece na hora de gravar.
O sétimo é a fatia [::-1], que funciona no PC e não funciona na placa, e é a razão pela qual a seção das fatias existe.
Exercício: analisar um e-mail
Escreva um programa que leia um e-mail, tire os espaços das pontas, passe tudo para minúsculas e mostre o usuário, o domínio, a extensão (a última parte do domínio) e as iniciais das partes do usuário separadas por ponto. Se o texto não tiver @, ele deve avisar que é inválido.
email = input("email: ").strip().lower()
if "@" not in email:
    print("invalido")
else:
    usuario, dominio = email.split("@")
    print("usuario", usuario)
    print("dominio", dominio)
    print("extensao", dominio.split(".")[-1])
print("iniciais", "".join(p[0].upper() for p in usuario.split(".")))Com a entrada Ana.Silva@Escola.com.br, as quatro linhas finais são usuario ana.silva, dominio escola.com.br, extensao br e iniciais AS. O split("@") separa as duas partes, e o desempacotamento do artigo sobre tuplas as entrega em usuario e dominio. O split(".")[-1] pega a última parte do domínio, e a compreensão pega a primeira letra de cada parte do usuário. Para treinar, trate o caso de um e-mail com dois @, que hoje quebra o desempacotamento, e verifique se a extensão tem pelo menos dois caracteres.
Perguntas frequentes
Posso alterar uma letra de um texto? Não. Monte outro texto com fatias, como "J" + s[1:], ou converta para lista com list(s), altere e junte de volta com "".join(...).
Qual a diferença entre find e index? O find devolve -1 quando não acha, e o index dá ValueError. Escolha pelo que a ausência significa no seu programa.
Aspas simples ou duplas? Tanto faz, e o resultado é o mesmo. Use as que evitam escapar: "it's" ou 'diz "oi"'.
Como comparo textos sem diferenciar maiúsculas? Passe os dois para lower() antes de comparar. Com letras acentuadas, lembre da limitação do upper e do lower no MicroPython.
Como junto números e textos numa linha só? Com f-string, que converte sozinha: f"{nome} tem {idade} anos".
O split() sem argumento é igual ao split(" ")? Não. O sem argumento trata qualquer sequência de espaços como um separador só e ignora os das pontas. O split(" ") corta em cada espaço, e dois espaços seguidos geram um item vazio.
Para continuar
Os desafios Tamanho do Nome, Repetir Texto e Comparar Textos praticam o len, a repetição e a comparação de textos. Para rever as bases, os artigos sobre print e input, conversão de tipos e dicionários completam este.
O próximo artigo trata das matrizes: listas de listas para guardar tabelas com linhas e colunas, como percorrê-las com laços aninhados e onde elas aparecem em projetos com a placa.